- DSX MaxLPS로 랙 간 전력 재분배…GPU 용량 최대 40% 늘리고 그록 3 LPX는 메가와트당 토큰 최대 35배
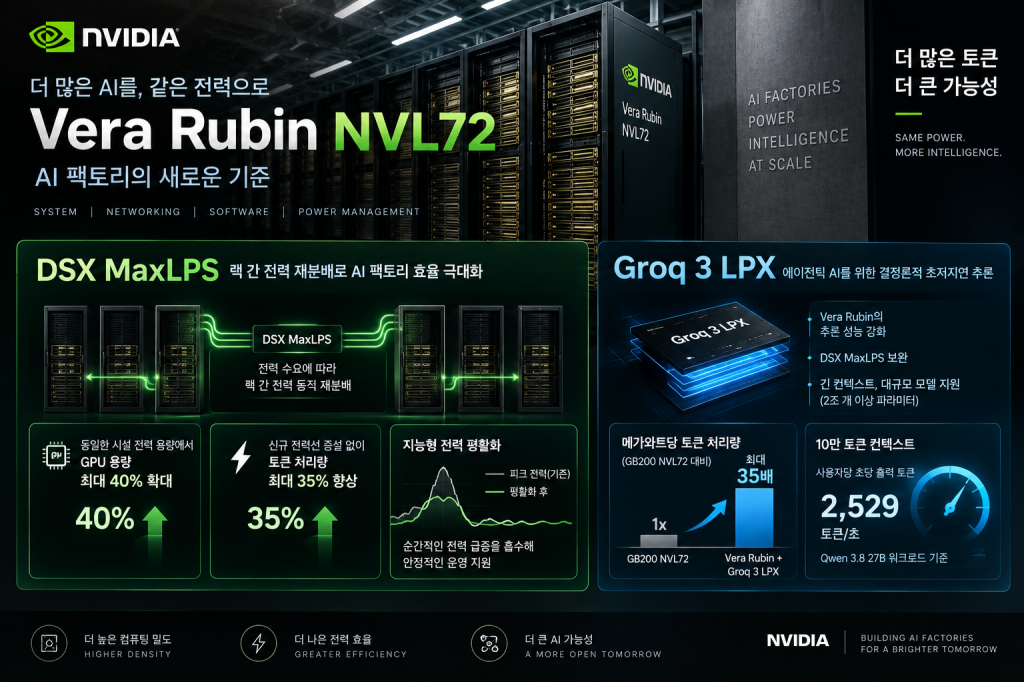
엔비디아가 베라 루빈 NVL72(Vera Rubin NVL72)와 그록 3 LPX(Groq 3 LPX)를 기반으로 AI 팩토리에서 동일한 전력으로 처리하는 토큰을 늘린다. DSX MaxLPS는 워크로드의 전력 수요에 따라 랙 사이의 전력을 동적으로 재분배하며, 그록 3 LPX는 베라 루빈에 결정론적 초저지연 추론 기능을 더해 에이전틱 AI 워크로드를 처리한다.
DSX MaxLPS로 랙 간 전력 재분배
AI 팩토리에서는 시설에 공급할 수 있는 전력이 GPU와 서버를 추가하는 데 직접적인 제약으로 작용한다. 엔비디아는 베라 루빈 NVL72를 기반으로 시스템과 네트워킹, 소프트웨어, 전력 관리를 결합하고 DSX MaxLPS를 통해 AI 팩토리의 전력 수요 변화에 맞춰 랙 사이의 전력을 동적으로 재분배한다.
엔비디아에 따르면 동일한 시설 전력 용량에서 GPU 용량을 최대 40% 늘리고, 별도의 전력선 증설 없이 토큰 처리량을 최대 35% 높인다. 각 랙에서는 지능형 전력 평활화(Intelligent Power Smoothing) 소프트웨어와 확장된 에너지 버퍼링 기능이 순간적인 전력 급증을 흡수해 랙의 전력 수요 변동을 줄인다. DSX MaxLPS는 이 과정에서 확보한 전력 여유분을 다른 랙의 컴퓨팅 자원에 재할당한다.
그록 3 LPX로 에이전틱 AI 초저지연 추론
에이전틱 AI는 여러 단계의 추론과 도구 호출을 연속해서 수행하기 때문에 컨텍스트가 길어질수록 처리해야 할 토큰과 지연 시간에 대한 부담이 커진다. 그록 3 LPX는 베라 루빈에 결정론적 초저지연 추론 기능을 추가해 DSX MaxLPS의 전력 관리 기능을 보완한다.
긴 컨텍스트 환경에서 2조 개 이상의 파라미터를 갖춘 모델을 기준으로 베라 루빈과 그록 3 LPX를 통합한 플랫폼은 GB200 NVL72 대비 메가와트당 토큰 처리량을 최대 35배 높였다.
10만 토큰 컨텍스트서 초당 2529개 출력 토큰
10만 토큰 컨텍스트 규모의 큐웬(Qwen) 3.8 27B 워크로드에서 그록 3 LPX는 사용자당 초당 2529개의 출력 토큰을 기록했다. 엔비디아는 이 같은 성능을 바탕으로 워크로드가 확장되더라도 같은 응답 시간 안에서 에이전트가 더 많은 추론 단계와 도구 호출을 수행할 수 있다고 설명했다.
#엔비디아 #NVIDIA #베라루빈 #VeraRubin #NVL72 #Groq3LPX #그록3LPX #DSX #DSXMaxLPS #AI팩토리 #에이전틱AI #Qwen #NVLink #AI인프라


