- Qwen·Gemma·YOLO 최적화 모델 제공…허깅페이스·MCP 통해 개발자·코딩 에이전트 접근
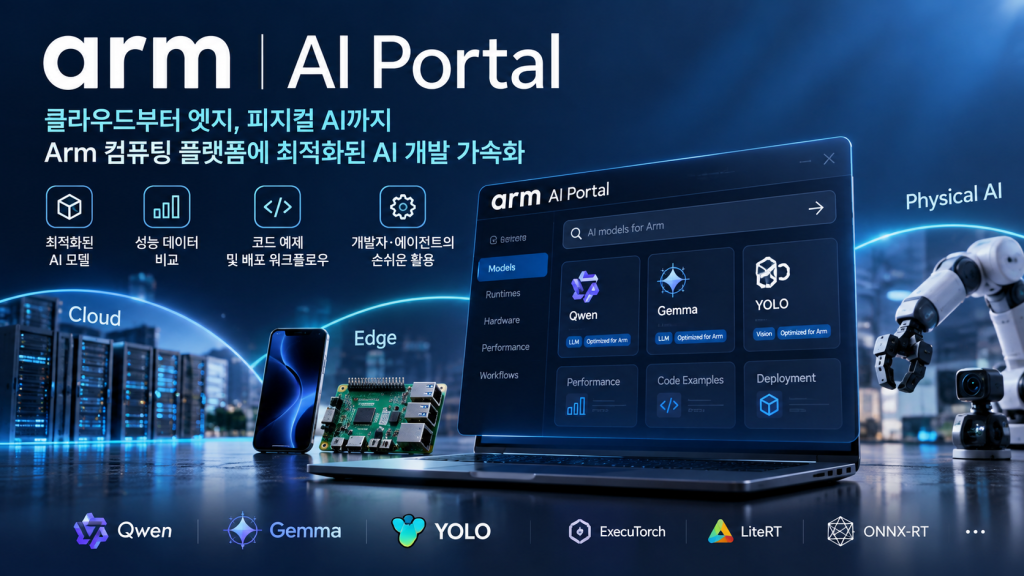
Arm이 AI 모델 탐색부터 성능 비교, 배포까지 개발 과정을 연결하는 ‘Arm AI 포털’을 공개했다. AI 포털은 클라우드와 엣지, 피지컬 AI에서 사용할 사전 최적화 모델과 성능 데이터를 제공하며, 개발자와 코딩 에이전트는 이를 바탕으로 Arm 컴퓨팅 환경에 맞는 AI 소프트웨어를 탐색하고 활용할 수 있다.
AI 애플리케이션 개발에서는 목표 하드웨어에 맞는 모델을 찾고 성능을 벤치마킹한 뒤 최적화하는 데 몇 주가 걸릴 수 있다. 개발자는 모델별 성능을 비교해야 하고, 에이전트가 개발에 참여하려면 모델과 도구, 관련 정보를 스스로 탐색할 수 있는 기준도 필요하다. Arm AI 포털은 이 과정을 하나의 환경에서 이어갈 수 있도록 모델과 성능 데이터, 워크플로우를 제공한다.
Qwen·Gemma·YOLO 사전 최적화 모델 제공
Arm AI 포털은 언어와 음성, 비전, 신경망 그래픽 영역에서 Arm 환경에 맞춰 사전 최적화한 AI 모델을 제공한다. 출시 시점에는 알리바바 큐원(Qwen), 구글 젬마(Gemma), 울트라리틱스 욜로(YOLO) 등을 지원하며, 이들 모델은 ExecuTorch와 LiteRT, ONNX-RT 등의 런타임을 활용한다. 알리바바와 라즈베리 파이, 울트라리틱스 등 에코시스템 파트너도 참여한다. 개발자는 모델별 성능과 정확도, 지연 시간, 메모리 사용량과 크기를 비교해 목표 하드웨어에 맞는 모델을 선택하고, 코드 예제와 배포 워크플로우를 확인할 수 있다.
Arm은 향후 개발자가 자체 개발한 모델이나 독점 모델을 AI 포털로 가져와 Arm 기반 환경에서 성능을 분석하고 최적화하는 도구를 제공할 예정이다. 에이전트용 AI 리소스는 정식 출시에 앞서 얼리 액세스로 제공한다.
허깅페이스·MCP로 개발자와 에이전트 연결
Arm에 최적화한 모델은 허깅페이스를 통해 제공하며, 코딩 에이전트는 모델 컨텍스트 프로토콜(MCP)을 이용해 AI 포털의 모델과 성능 데이터, 개발 리소스에 접근한다. AI 포털은 모델과 성능 데이터, 워크플로우를 머신 디스커버러블 형태로 제공하며, 에이전트는 이를 바탕으로 필요한 리소스를 탐색한다. 개발자와 에이전트는 기존 개발 환경에서 Arm의 AI 모델과 리소스를 활용할 수 있다.
Qwen3-TTS 4배·YOLO26n 40% 이상 성능 향상
Arm이 공개한 최적화 결과에 따르면 큐원3-TTS(Qwen3-TTS)는 비보 X300 스마트폰에서 단일 스레드 실행과 혼합 양자화를 적용해 4배 이상의 속도 향상을 기록했다. 토커와 코드 예측기에는 Q8_0을 적용하고, SME2로 연산 성능을 높였다. 울트라리틱스 YOLO26n은 비보 X300과 라즈베리 파이 5에서 모두 40% 이상의 성능 향상을 기록했다. 비보 X300에서는 SME2를 적용하고 FP32 대신 FP16으로 단일 스레드를 실행했으며, 라즈베리 파이 5에서는 NEON을 적용해 FP32 대신 FP16과 INT8 혼합 양자화를 사용했다.
클라우드부터 스마트폰·로보틱스까지 연결
AI 포털은 로보틱스용 비전 모델부터 스마트폰용 생성형 AI, 클라우드 CPU에서 실행하는 작업별 대규모 언어 모델(LLM)까지 목표 플랫폼에 맞는 모델을 찾도록 지원한다. SVE와 SME, 신경망 가속기 등 Arm 기술에는 해당 하드웨어에 최적화된 소프트웨어를 연결한다.
Arm CSS for Mobile 2가 대표적인 사례다. 개발자는 AI 포털에서 SME2로 가속한 모델과 신경망 가속기를 탑재한 GPU를 이용할 수 있다. Arm은 이를 통해 2,200만 명 이상의 개발자와 에이전트가 대상 하드웨어에 최적화된 AI 소프트웨어를 찾고 활용하도록 지원한다.
#Arm #ArmAI포털 #AI포털 #에이전틱AI #AI개발 #MCP #허깅페이스 #Qwen #Gemma #YOLO #SME2 #피지컬AI #엣지AI


