- Xe 3P 기반 32개 Xe 코어·256개 XMX 엔진 탑재…RTX PRO 6000 대비 금융 모델링 처리량 최대 5.9배
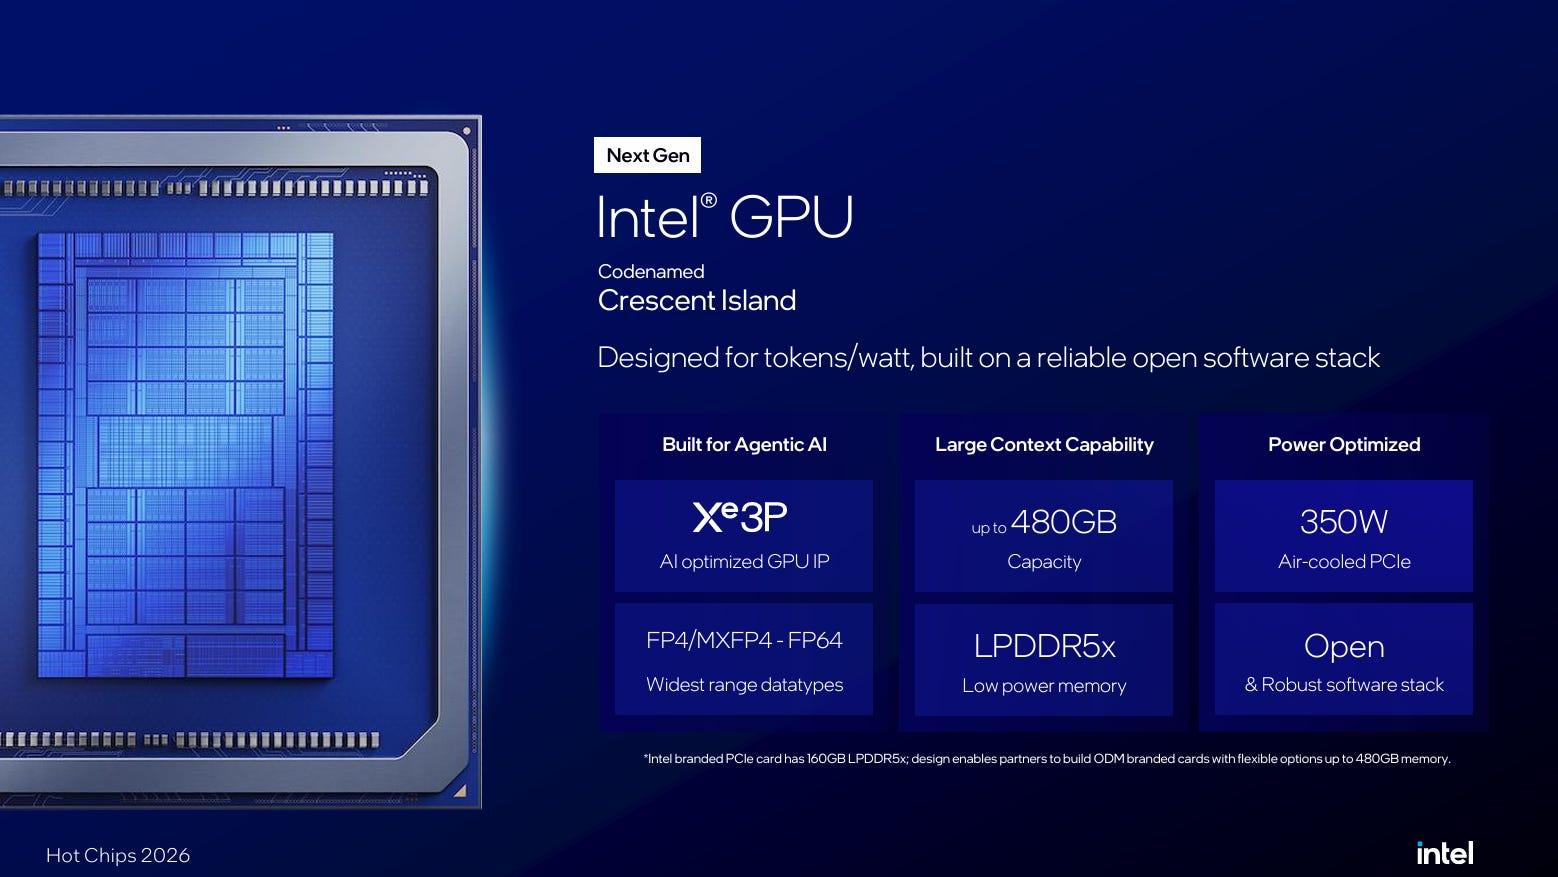
인텔이 코드명 ‘크레센트 아일랜드(Crescent Island)’인 인텔 GPU D270을 AI 추론뿐 아니라 고성능 컴퓨팅(HPC) 워크로드에도 활용할 수 있다고 밝혔다. 인텔 GPU D270은 Xe 3P 아키텍처를 기반으로 네이티브 FP64 연산과 160GB LPDDR5X 메모리를 지원하며, 금융 모델링과 지진파 영상화 등 높은 연산 정밀도와 대용량 메모리가 필요한 작업을 처리한다.
HPC 환경에서는 수치 모델링과 시뮬레이션에 데이터 분석과 AI 추론을 결합해 연속된 워크플로우로 처리하는 방식이 확산되고 있다. 사전 학습된 AI 대리 모델은 본격적인 수치 해석 솔버를 실행하기 전에 수십만 개의 설계 매개변수를 분석해 후보를 선별하고, 에이전틱 의사결정 모델은 시뮬레이션 텔레메트리 데이터를 실시간으로 모니터링해 불안정성을 감지하고 메시 경계를 조정하거나 다음 연산 단계를 결정한다.
네이티브 FP64와 160GB 메모리로 HPC 연산
인텔 GPU D270은 Xe 3P 아키텍처에 32개 Xe 코어와 256개 Xe 매트릭스 익스텐션(XMX) 엔진을 탑재했다. 각 코어에서 64회의 FP64 융합 곱셈-덧셈(FMA) 연산을 지원하며, AI 추론에 사용하는 FP4·FP8 저정밀도부터 수학적 정확도가 필요한 HPC 작업의 네이티브 FP64까지 워크로드에 따라 정밀도를 선택한다.
인텔 브랜드 카드는 160GB LPDDR5X 메모리와 초당 1.5TB의 메모리 대역폭을 제공하며, 파트너사 구성에서는 최대 480GB까지 메모리 용량을 확장할 수 있다. 대규모 데이터셋과 파동장(wavefield)을 GPU 메모리에 상주시켜 호스트 버스를 통한 데이터 이동을 줄인다. 350W 전력 설계와 PCIe 5.0 기반 표준 공랭식 폼팩터를 적용해 일반 엔터프라이즈 서버부터 멀티 랙 환경까지 배치할 수 있다.
금융 모델링 처리량 최대 5.9배
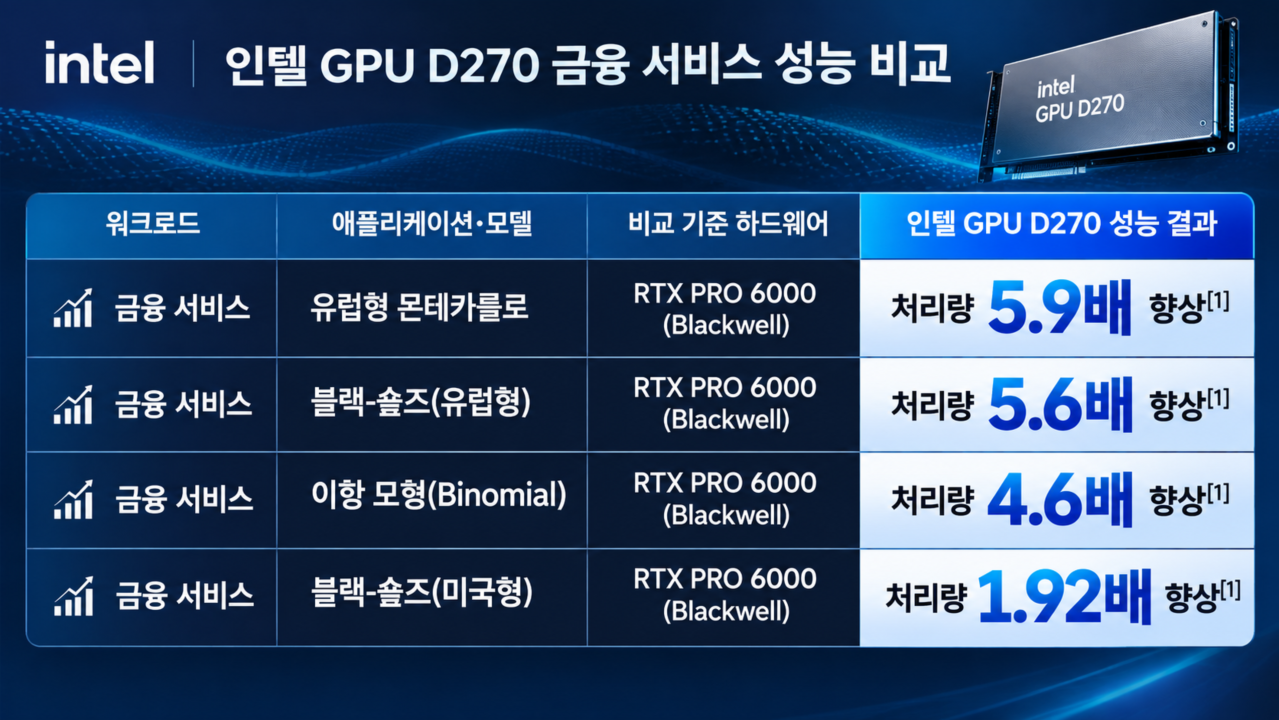
양산 전 실리콘을 기반으로 실시한 금융 서비스 애플리케이션 벤치마크에서 인텔 GPU D270은 엔비디아 RTX PRO 6000 블랙웰 서버 에디션 대비 유럽형 몬테카를로 모델에서 5.9배 높은 처리량을 기록했다. 유럽형 블랙-숄즈에서는 5.6배, 이항 모형 4.6배, 미국형 블랙-숄즈 1.92배를 기록했다. 비교 대상 GPU는 600W를 소비한 반면 D270은 350W로 테스트했다.
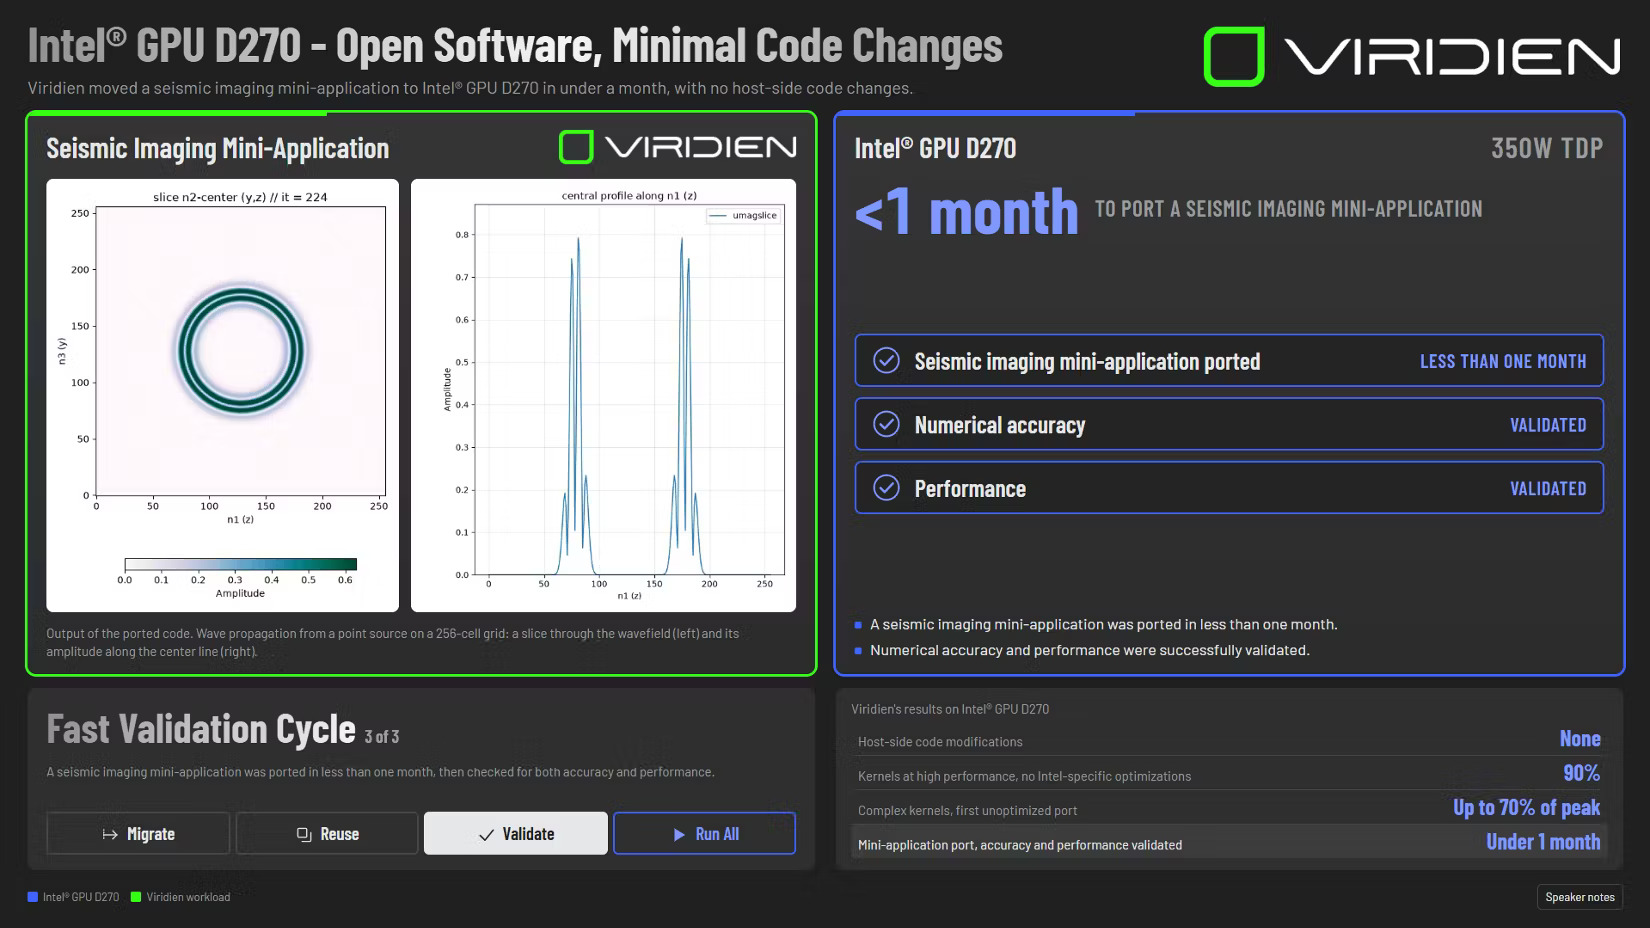
지진파 모델링에서는 대규모 3D 음향 파동 전파를 FP32로 연산한다. 캐시 특성을 고려한 스텐실 최적화로 로컬 캐시의 데이터 재사용을 늘리고 대규모 파동장 배열을 GPU 메모리에 상주시켜 데이터 이동을 줄인다. 인텔은 시카고에서 열리는 슈퍼컴퓨팅 2026(SC26) 전시 부스에서 베리디언(Veridien)의 지진파 모델링 워크로드를 실시간으로 시연할 예정이다.
D270·삼바노바 RDU·제온이 추론 단계별 분담
AI 추론이 시뮬레이션 실행 과정에 직접 들어가면서 연산 단계별로 적합한 프로세서를 배치하는 분리형 컴퓨팅의 필요성도 커지고 있다. 단일 컴퓨팅 노드에서는 서로 다른 연산 단계가 같은 프로세서를 공유해 자원 경쟁과 지연이 발생할 수 있기 때문이다.
분리형 환경에서 인텔 GPU D270은 연산 집약적인 프리필(prefill)을 맡아 고차원 시뮬레이션 데이터셋과 대규모 프롬프트, 과학 분야의 컨텍스트 윈도우를 처리한다. 메모리 의존도가 높은 디코드(decode)는 삼바노바 SN50 재구성 가능 데이터플로 유닛(RDU)이 가속하며, 인텔 제온 6과 제온 6+ 프로세서는 엔드투엔드 워크플로 오케스트레이션과 호스트 통신, 도구 실행을 담당한다.
인텔과 삼바노바는 D시리즈 GPU와 RDU를 조합해 기존 공랭식 랙의 전력 한도 안에서 에이전틱 실행 루프를 구동하는 솔루션을 개발하고 있다. SC26에서는 D270과 SN50 RDU가 함께 작동하는 분리형 이기종 추론 아키텍처를 실시간으로 시연한다. HPC 센터와 연구기관은 이를 활용해 맞춤형 소프트웨어 오케스트레이션이나 저수준 스케줄링 계층을 별도로 개발하지 않고 AI 추론과 에이전틱 파이프라인을 운영할 수 있다.
개방형 소프트웨어로 기존 HPC 코드 활용
인텔은 기존 수치 시뮬레이션과 AI 워크로드를 하나의 개방형 소프트웨어 스택에서 지원한다. 인텔 MPI와 최적화된 포트란, 고성능 C++ 컴파일러를 제공하며, 표준 AI 프레임워크와 추론 런타임, 개방형 SYCL 프로그래밍 모델과의 업스트림 통합을 진행하고 있다. 연구팀은 기존 툴체인을 유지하면서 D270을 도입해 초기 단계부터 성능을 활용할 수 있다.
양산 전 실리콘 기반 AI 성능 테스트에서 D270은 Drex 2.0을 실행할 때 엔비디아 RTX PRO 6000 블랙웰 서버 에디션보다 최대 29% 낮은 지연 시간을 기록했다. Qwen 3 30B-A3B 모델에서는 같은 비교 대상보다 1.12배 높은 LLM 처리량을 보였으며, 전력 소비량은 350W였다.
베리디언의 지진파 모델링 데모도 SYCL을 활용해 기존 HIP·CUDA 워크로드 개발 과정에서 축적한 작업을 이어갔다. 호스트 측 코드를 수정하지 않고 SYCL로 마이그레이션했으며, 사전 컴파일(AOT)과 커널 번들을 결합해 기존 연산 커널을 재사용했다. 전체 커널의 90%는 인텔 전용 최적화 없이도 작동했으며, 복잡한 커널은 최초 이식 단계에서 별도의 최적화 없이 이론상 최고 성능의 최대 70%에 도달했다. 지진파 영상화 미니 애플리케이션은 한 달 이내에 이식을 마치고 수치적 정확도와 성능을 검증했다.
#인텔 #인텔GPUD270 #크레센트아일랜드 #HPC #고성능컴퓨팅 #Xe3P #FP64 #XMX #SYCL #에이전틱AI #AI추론 #SC26


