- 큐웬 3.6 기반으로 1,200억 파라미터급 에이전틱 AI 구현 지원
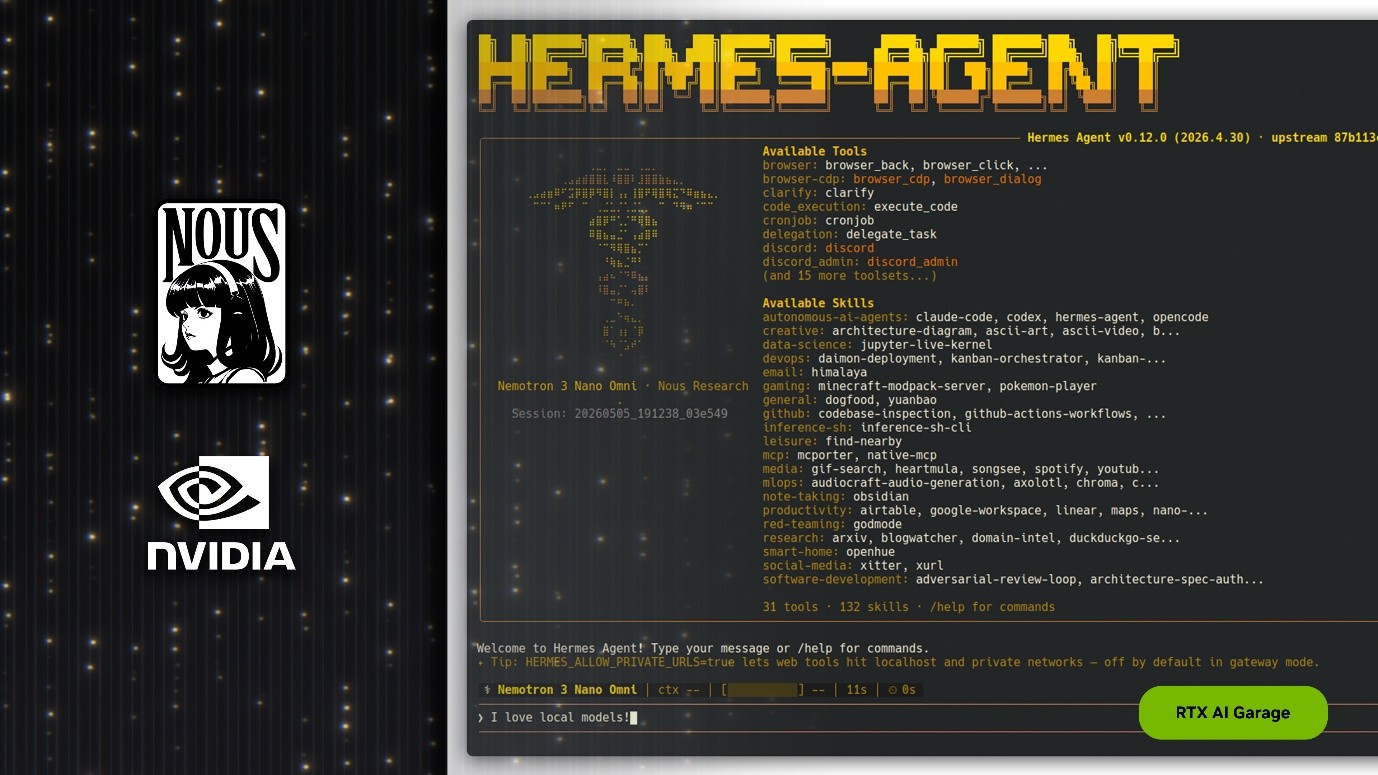
엔비디아(NVIDIA)가 RTX PC와 DGX 스파크에서 누스 리서치(Nous Research)의 로컬 AI 에이전트 ‘헤르메스(Hermes)’를 지원하며, 로컬 환경 기반 에이전틱 AI를 상시 실행하고 자체 개선형 워크플로우를 가속한다.
헤르메스는 특정 모델이나 공급업체에 종속되지 않는 오픈소스 AI 에이전트다. 메시징 앱 연동과 로컬 파일 접근, 애플리케이션 실행 기능을 기반으로 24시간 상시 동작하도록 설계됐다. 최근 깃허브(GitHub) 스타 14만 개를 돌파했고, 오픈라우터(OpenRouter) 기준 전 세계에서 가장 많이 사용되는 AI 에이전트 가운데 하나로 자리잡았다. 엔비디아는 RTX PC와 RTX PRO 워크스테이션, DGX 스파크를 통해 헤르메스 실행 환경을 가속한다. 텐서 코어(Tensor Cores)는 AI 추론 속도를 높이고 지연 시간을 줄여 다단계 작업 처리 성능을 높인다.
큐웬 3.6 기반 로컬 에이전트 확대
알리바바(Alibaba)의 큐웬(Qwen) 3.6 모델도 헤르메스 실행 환경에 맞춰 설계됐다. 큐웬 3.6 35B 모델은 약 20GB 메모리만으로 기존 1,200억 파라미터 모델급 성능을 구현하며, 큐웬 3.6 27B 역시 이전 4,000억 파라미터급 모델 수준의 정확도를 유지하면서 모델 크기를 크게 줄였다. 헤르메스는 작업 수행 과정에서 새로운 기술과 작업 패턴을 자체 저장하며 성능을 개선한다. 단기 독립형 서브 에이전트를 함께 운영해 하위 작업별 컨텍스트와 도구 세트를 분리하고, 작은 컨텍스트 윈도우 기반 로컬 모델 환경에서도 안정적인 실행 성능을 유지한다.
누스 리서치는 헤르메스에 적용되는 기술과 플러그인을 사전에 검증하고 스트레스 테스트를 진행했다. 엔비디아는 이러한 설계가 300억 파라미터급 로컬 모델 환경에서도 안정적인 실행 성능을 유지한다고 설명했다.
DGX 스파크, 상시 실행형 에이전틱 컴퓨터
DGX 스파크는 하루 종일 지속되는 에이전틱 AI 워크플로우를 처리하도록 설계된 독립형 시스템이다. 128GB 통합 메모리와 1페타플롭급 AI 성능을 기반으로 1,200억 파라미터 규모 전문가형 혼합(MoE) 모델도 상시 실행한다. 엔비디아는 DGX 스파크와 RTX GPU 환경에서 헤르메스를 라마.cpp(llama.cpp), LM 스튜디오(LM Studio), 올라마(Ollama)와 함께 실행할 수 있다고 설명했다. LM 스튜디오와 올라마는 헤르메스를 기본 지원하며 로컬 AI 에이전트 구축 과정도 단순화한다.
엔비디아는 최근 로컬 모델 지원과 보안 기능을 강화한 오픈소스 스택 ‘네모클로(NemoClaw)’도 공개했다. 네모클로는 WSL2를 지원하며 DGX 스파크 기반 자율형 AI 에이전트 구축 환경까지 함께 제공한다. 엔비디아는 RTX AI 개러지(RTX AI Garage)를 통해 최신 오픈 모델과 RTX 하드웨어 기반 에이전틱 AI 업데이트를 지속 공개할 계획이다.
#엔비디아 #RTX #DGXSpark #헤르메스 #Hermes #에이전틱AI #큐웬36 #Qwen36 #로컬AI #MoE


