- 검색·AI 학습·AI 에이전트 각각 설정…애플·구글·마이크로소프트 ‘책임 있는 크롤러’ 지정
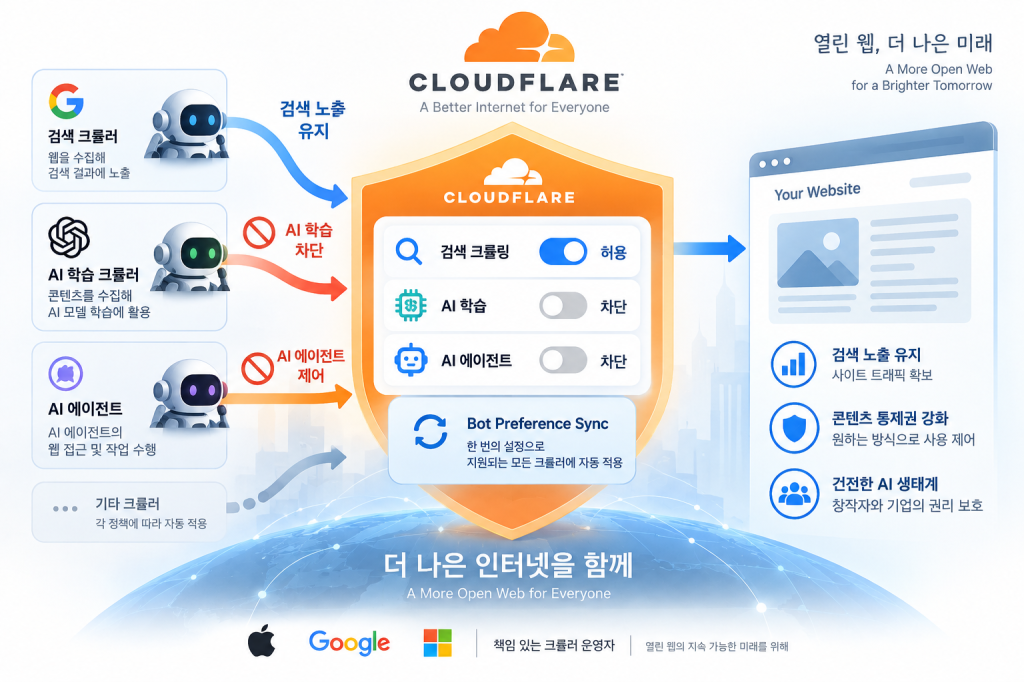
클라우드플레어(Cloudflare)가 웹사이트의 검색 노출을 유지하면서 콘텐츠의 AI 학습은 차단하는 ‘Disallow AI Training’을 출시했다. 검색과 AI 학습에 하나의 크롤러를 사용하더라도 두 용도를 구분하고, 검색·AI 학습·AI 에이전트별로 접근 정책을 각각 설정하는 방식이다.
검색과 AI 학습을 별도로 제어
검색엔진 크롤러는 웹사이트 콘텐츠를 수집해 검색 결과에 노출하고 사이트로 이용자를 유입해 왔다. 생성형 AI 확산 이후에는 하나의 크롤러가 검색 색인과 AI 모델 학습에 콘텐츠를 함께 사용하는 사례가 늘면서 웹사이트 운영자가 AI 학습을 거부할 경우 검색 노출까지 포기해야 하는 문제가 발생했다.
클라우드플레어에 따르면 혼합 사용 크롤러는 자사 네트워크에서 검증된 크롤러 트래픽의 36.6%를 차지한다. 검색 크롤링을 차단하는 웹사이트는 1% 미만이지만 AI 학습을 제한하는 비율은 17%로 집계됐다.
클라우드플레어는 기존 ‘Block AI Bots’를 검색과 AI 학습, AI 에이전트를 각각 설정하는 세 가지 제어 기능으로 대체했다. 신규 웹사이트 가운데 광고를 게재하는 사이트에는 검색 크롤링을 허용하면서 AI 학습과 광고 페이지의 AI 에이전트 접근을 차단하도록 권장하며, 광고 수익에 의존하지 않는 사이트에는 세 가지 접근을 모두 허용하도록 제안한다.
크롤링 선호 설정 한 번에 적용
기존 ‘Managed Robots.txt’ 기능은 ‘Bot Preference Sync’로 대체한다. 웹사이트 운영자가 검색과 AI 학습, AI 에이전트에 대한 크롤링 선호 사항을 한 번 설정하면 지원되는 모든 크롤러에 자동으로 반영하며, 필요할 때 언제든 변경할 수 있다.
AI 학습 거부해도 검색 순위 유지
클라우드플레어는 혼합 사용 크롤러가 ‘책임 있는’ 운영자로 인정받기 위한 네 가지 기준도 마련했다. AI 학습과 AI 생성 검색 요약을 각각 거부할 수 있어야 하며, 콘텐츠가 검색과 학습에 어떻게 사용되는지 URL 단위로 확인할 수 있도록 해야 한다. AI 학습을 거부하더라도 기존 검색에서 사이트 순위에 영향을 미치지 않는다는 점도 공개적으로 확인해야 한다.
애플과 구글, 마이크로소프트는 이 기준을 충족했거나 충족하기 위한 구체적인 일정을 제시했다. 구글은 ‘Google-Extended’를 통해 웹사이트가 구글 검색을 유지하면서 AI 학습 이용을 거부하도록 지원한다. 검색과 학습에 별도의 크롤러를 운영하는 AI 기업의 경우 클라우드플레어가 검색 크롤러에는 영향을 주지 않고 학습 크롤러만 차단할 수 있다.
클라우드플레어 매튜 프린스(Matthew Prince) CEO는 “검색의 가치를 높이는 개방성을 유지하면서 웹을 만들어 가는 사람과 기업이 자신의 작업물이 사용되는 방식을 실질적으로 제어할 수 있도록 하는 것”이라며 “건전한 생태계를 함께 구축해 나가는 과정에서 애플, 구글, 마이크로소프트와 지속적으로 협력하기를 기대한다”고 밝혔다.
#클라우드플레어 #Cloudflare #DisallowAITraining #AI크롤러 #AI학습 #AI에이전트 #검색엔진 #robots.txt #AICrawlControl


