- 최대 192GB 통합 메모리
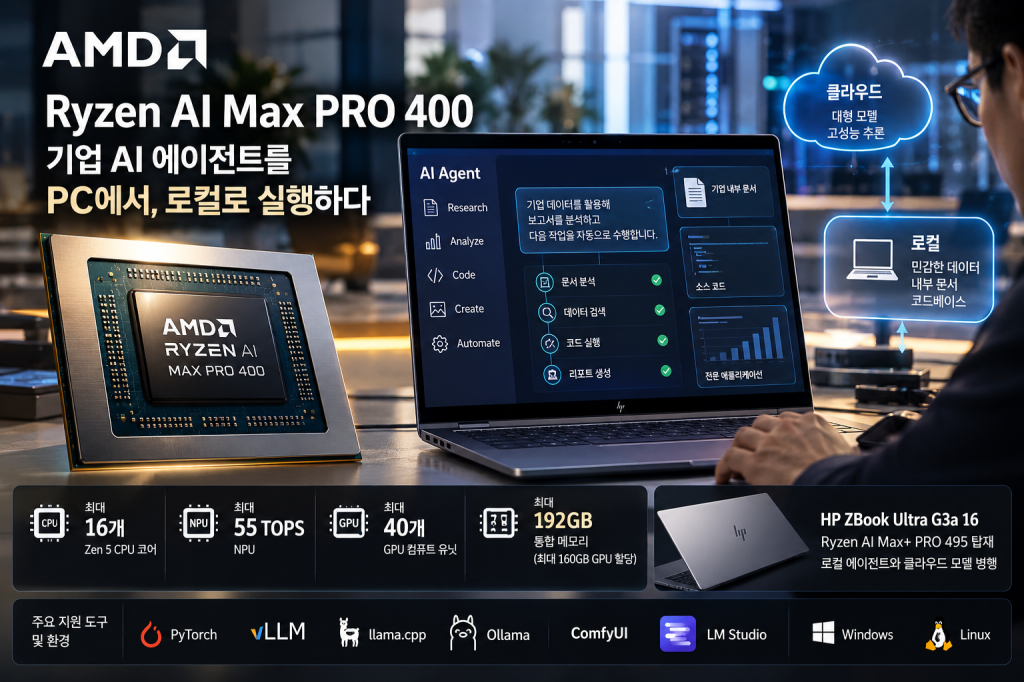
·160GB GPU 할당…3000억개 이상 파라미터 모델도 클라우드 오프로딩 없이 처리
AMD가 Ryzen AI Max 400과 Ryzen AI Max PRO 400 시리즈를 기반으로 기업용 AI 에이전트를 PC에서 직접 개발·실행하는 로컬 AI 환경을 공개했다. 최대 192GB 통합 메모리 가운데 160GB까지 GPU에 할당해 여러 AI 모델과 기업 데이터, 애플리케이션을 한 시스템에서 처리한다. 최대 16개 Zen 5 CPU 코어와 55 TOPS NPU, 40개 GPU 컴퓨트 유닛도 탑재했다.
Ryzen AI Max PRO 400 시리즈는 4비트 양자화 기준 3000억개 이상의 파라미터를 갖춘 AI 모델을 클라우드로 넘기지 않고 PC에서 구동한다. AMD는 Ryzen AI Max+ PRO 495가 이를 지원하는 첫 x86 클라이언트 프로세서라고 설명했다.
192GB 통합 메모리로 에이전틱 AI 작업 처리
AI 에이전트는 일반적인 생성형 AI 챗봇과 달리 여러 애플리케이션과 도구를 연결해 다단계 작업을 수행한다. 설정에 따라 일부 작업을 스스로 실행하며, 사용자가 다른 업무를 수행하는 동안 장시간 이어지는 작업도 처리한다.
여러 AI 모델과 긴 컨텍스트 윈도, 기업 데이터와 애플리케이션을 동시에 다루는 만큼 메모리 요구량도 커진다. Ryzen AI Max 400 시리즈는 이전 세대의 최대 128GB 통합 메모리와 96GB GPU 할당을 각각 192GB와 160GB로 늘렸다. GPU에 할당할 수 있는 메모리는 이전 세대의 약 1.67배다.
기업용 AI 에이전트 개발은 기반 모델 실행뿐 아니라 내부 문서와 코드베이스 연결, 검색증강생성(RAG) 애플리케이션 개발, 여러 모델 평가까지 포함한다. 에이전트가 사용할 도구와 커넥터를 개발·검증하고, 작업 특성에 따라 로컬에서 처리할 영역과 클라우드 모델에 맡길 영역도 나눈다.
CPU·GPU·NPU 결합해 개발부터 실행까지 지원
Ryzen AI Max PRO 400 시리즈는 Zen 5 CPU와 내장 그래픽, NPU, 통합 메모리를 결합해 모델 개발과 오케스트레이션, 프로토타이핑부터 실행까지 하나의 시스템에서 처리한다. 운영체제는 Windows와 Linux를 지원하고, PyTorch와 vLLM, llama.cpp, Ollama, ComfyUI, LM Studio 등 AI 개발 도구와 프레임워크를 사용할 수 있다.
최상위 Ryzen AI Max+ PRO 495는 16코어 32스레드 CPU와 라데온 8065S 그래픽, 40개 그래픽 컴퓨트 유닛, 최대 55 TOPS NPU를 탑재한다. Ryzen AI Max PRO 490은 12코어 24스레드 CPU와 32개 그래픽 컴퓨트 유닛, 최대 50 TOPS NPU로 구성되며, Ryzen AI Max PRO 485는 8코어 16스레드 CPU를 적용했다. 세 제품 모두 최대 192GB 통합 메모리를 지원한다.
민감 데이터는 로컬에서, 필요한 작업은 클라우드로
AMD는 기업용 AI를 로컬과 클라우드 가운데 하나만 선택하기보다 워크로드에 따라 처리 위치를 나누는 하이브리드 운용에 초점을 맞췄다. 내부 문서와 엔지니어링 파일, 소스코드 등 민감한 데이터는 PC에서 처리하고, 로컬 모델로 처리하기 어려운 작업은 클라우드의 대형 모델에 맡긴다. 이를 통해 모든 요청과 작업 문서를 외부 추론 서비스로 보내지 않고 데이터가 처리되는 위치를 기업이 관리한다.
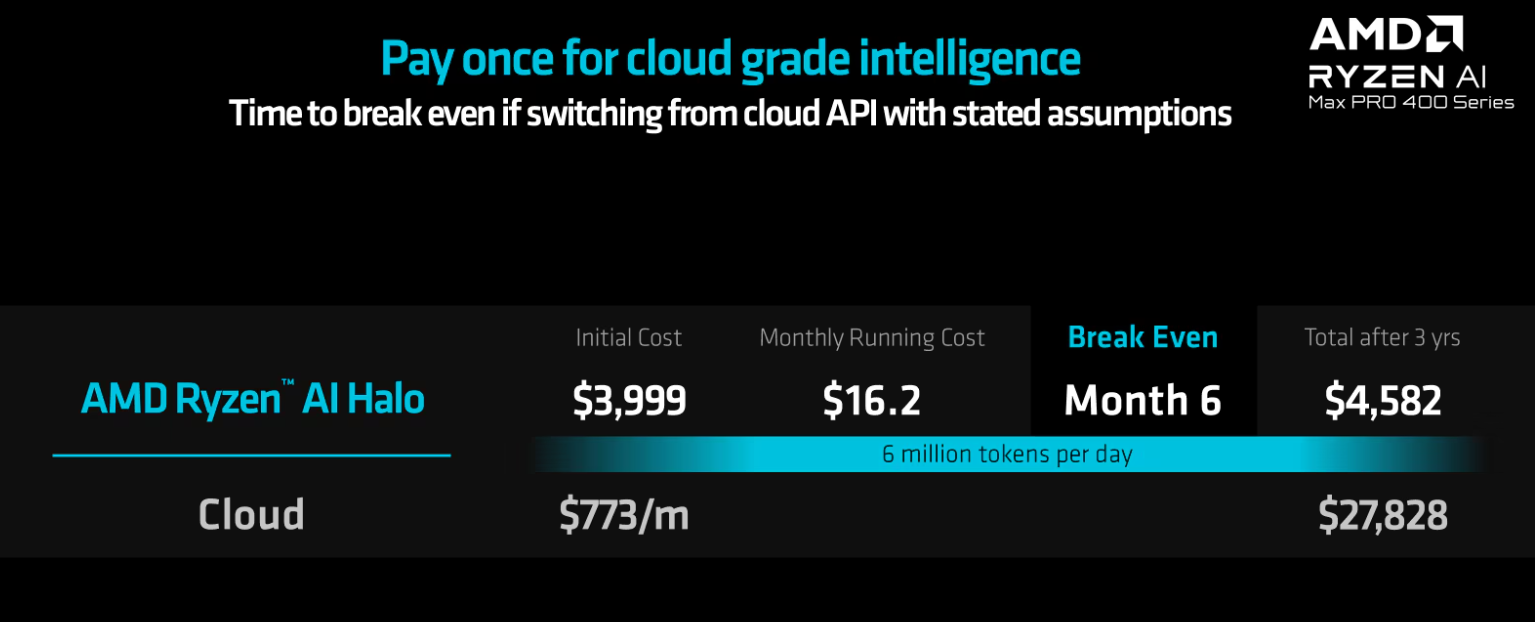
에이전틱 AI가 추론을 반복한다는 점도 로컬 실행을 고려하는 이유다. 하나의 작업을 수행하면서 추론과 수정, 정보 검색, 모델 호출을 반복해 일반적인 챗봇보다 많은 토큰을 사용할 수 있으며, 이를 클라우드에서 처리하면 모델 호출이 반복될 때마다 추론 비용이 발생한다.
AMD는 ‘토크노믹스 계산기(Tokenomics Calculator)’를 통해 사용자 수와 토큰 사용량, 하드웨어 요구사항, 클라우드 모델 가격을 바탕으로 클라우드 전용·로컬 전용·하이브리드 환경의 운용 비용을 비교하도록 했다. 필요한 고성능 추론은 클라우드에 맡기고 나머지 작업은 로컬에서 처리했을 때의 비용 차이를 비교해 배치 방식을 정할 수 있다.
HP 워크스테이션에서 로컬 에이전트와 클라우드 모델 병행
HP는 Ryzen AI Max+ PRO 495를 ‘ZBook Ultra G3a 16’에 탑재하고 퍼플렉시티의 ‘Portable Computer’를 적용했다. 로컬 AI 모델과 에이전트를 전문 애플리케이션과 함께 구동하고, 작업 과정에서 더 높은 수준의 모델이 필요할 때는 클라우드 모델을 활용한다.
AMD는 Ryzen AI Max 400과 Ryzen AI Max PRO 400 기반 시스템이 파트너사를 통해 공급되고 있다고 밝혔다. Ryzen AI Max PRO 400 시리즈는 상용 PC와 모바일 워크스테이션, 소형 데스크톱에서 AI와 그래픽, 전문 컴퓨팅 작업을 처리하도록 설계됐다.
#AMD #라이젠AI맥스PRO400 #RyzenAIMaxPRO400 #RyzenAIMax400 #에이전틱AI #로컬AI #AI에이전트 #AI워크스테이션 #통합메모리 #하이브리드AI #AI컴퓨팅


