- 베라 루빈 NVL72, GB300 대비 메가와트당 처리량 30배 이상…CUDA 기반 세대 간 호환으로 GPU 수명 연장
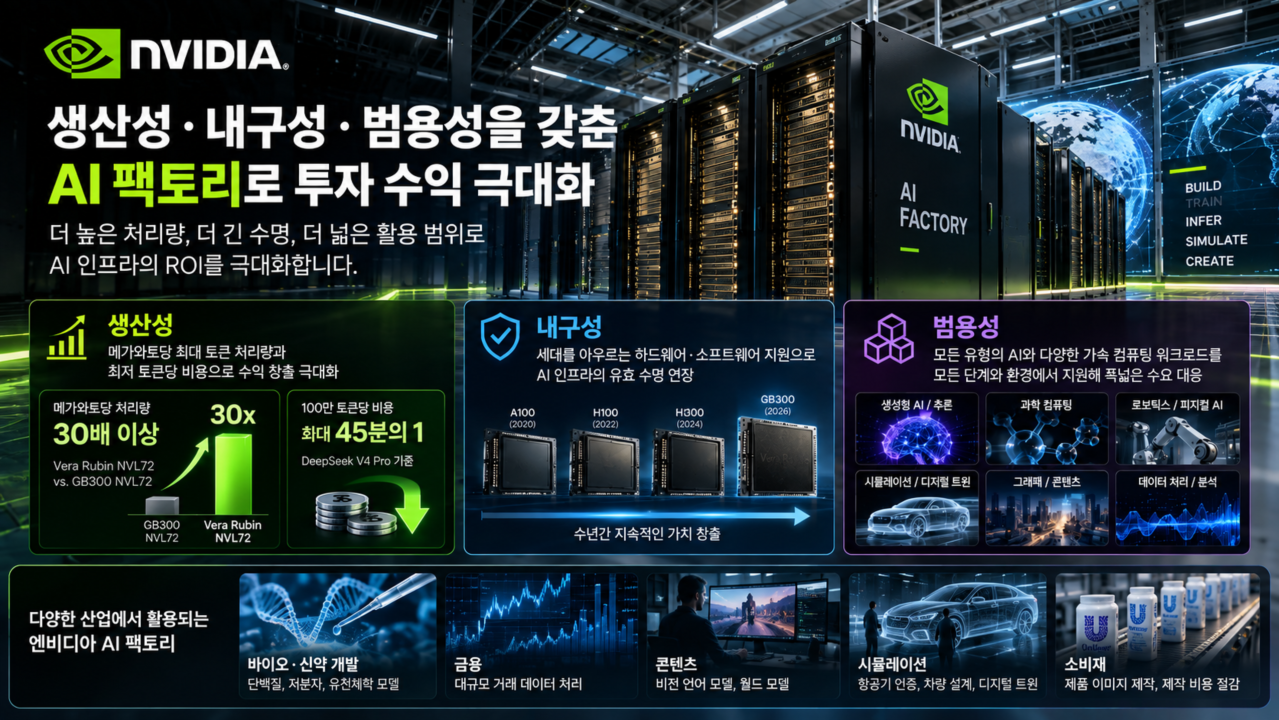
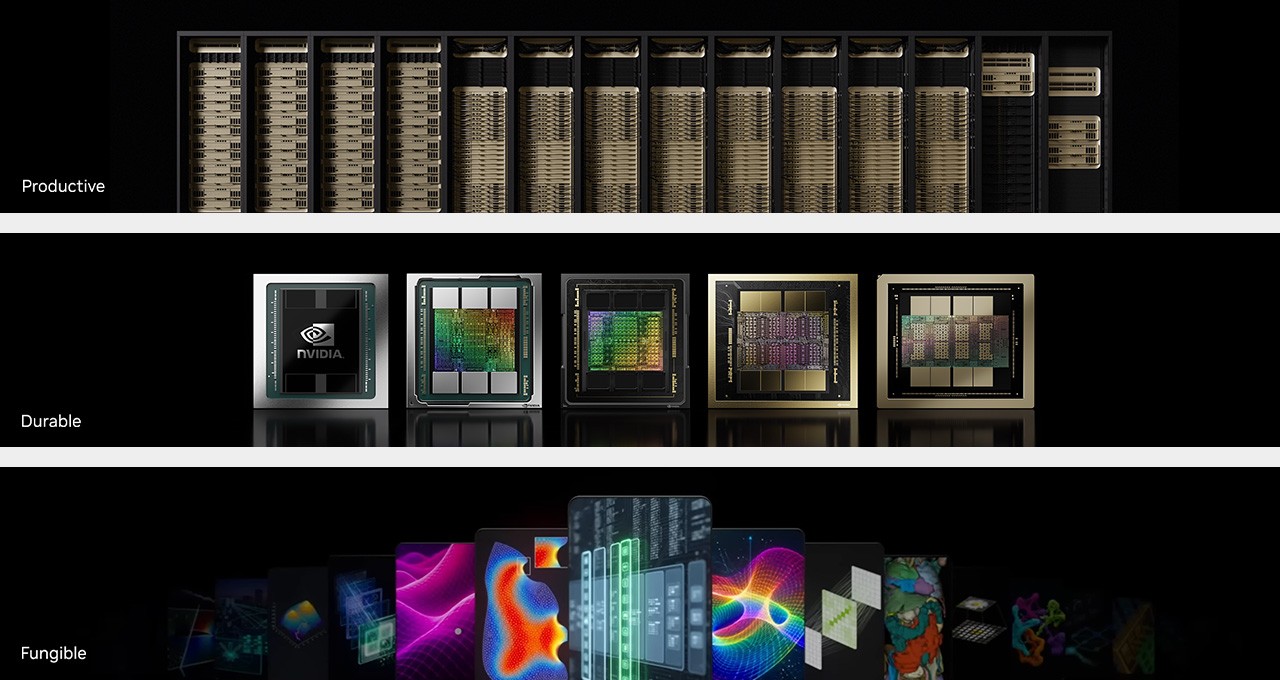
엔비디아가 AI 팩토리의 투자수익률(ROI)을 결정하는 핵심 요소로 수익 창출 능력과 하드웨어 유효 수명, 토큰 수요를 제시했다. 이를 높이기 위한 엔비디아 AI 팩토리의 핵심 경쟁력으로는 생산성·내구성·범용성을 꼽았다. 메가와트당 더 많은 토큰을 낮은 비용으로 처리하고, 기존 GPU를 여러 세대에 걸쳐 활용하면서 AI부터 과학 컴퓨팅·시뮬레이션·그래픽까지 하나의 플랫폼에서 실행해 컴퓨팅 자원의 활용 범위를 넓힌다는 설명이다.
AI 팩토리는 메가와트에서 기가와트 단위로 전력을 사용하는 대규모 컴퓨팅 인프라다. 엔비디아에 따르면 메가와트급 AI 팩토리 하나를 구축하는 데 약 6000만달러가 들어가는 만큼, 운영 기업은 초기 투자 이후 얼마나 많은 토큰을 판매할 수 있는지, 하드웨어가 얼마나 오래 수익을 창출하는지, 지속적인 수요를 확보할 수 있는지를 함께 고려해야 한다.
메가와트당 토큰 처리량이 AI 팩토리 수익 좌우
AI 팩토리에서 전력은 확장을 제한하는 핵심 제약 요소다. 이에 따라 엔비디아는 메가와트당 초당 토큰 처리량을 수익 창출 능력을 결정하는 주요 지표로 제시했다. 동일한 전력에서 더 많은 토큰을 생성하고 토큰당 처리 비용을 낮추면 AI 팩토리의 수익성을 높일 수 있다는 설명이다. 세미애널리시스 에이전트X 데이터에 따르면 엔비디아 베라 루빈(Vera Rubin) NVL72는 GB300 NVL72보다 메가와트당 처리량이 30배 이상 높다. 딥시크 V4 프로 모델에서는 100만 토큰당 비용을 최대 45분의 1 수준으로 낮춘다.
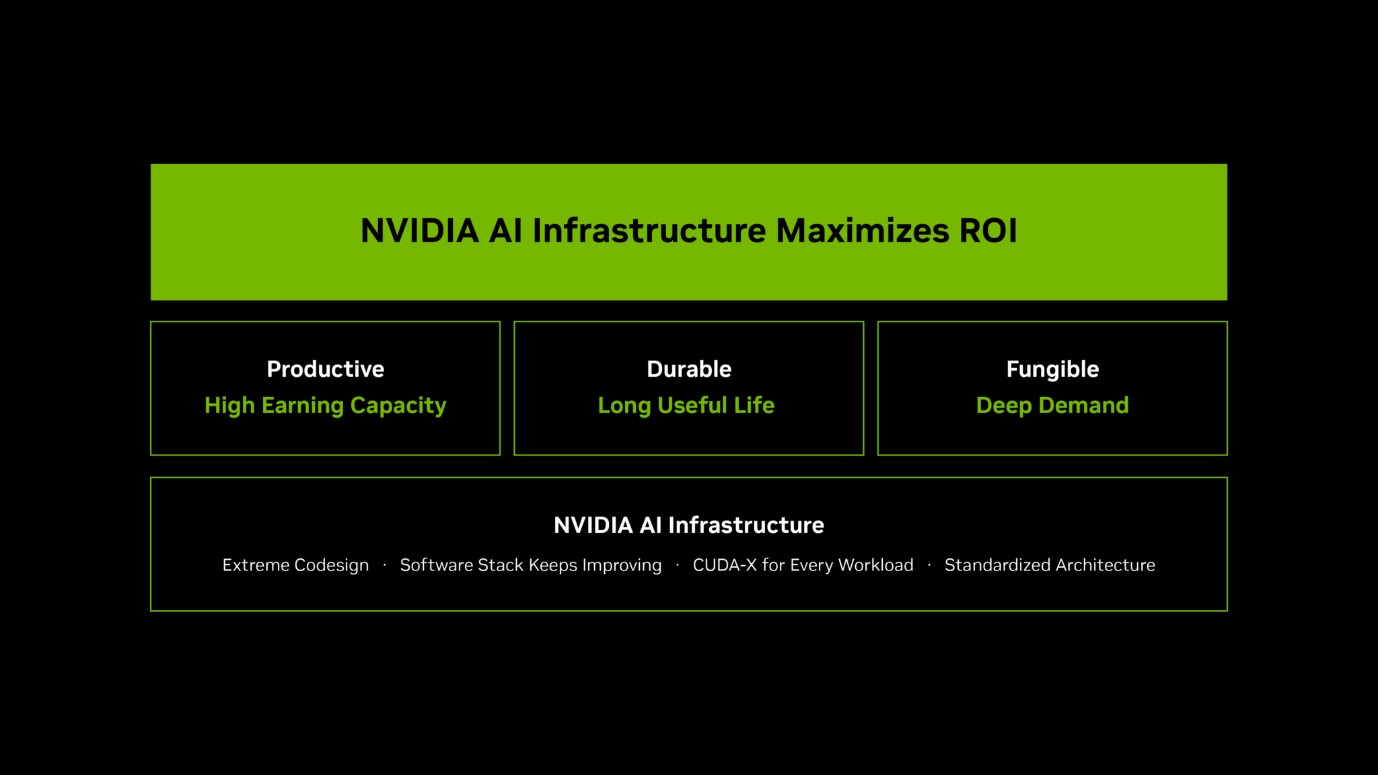
엔비디아는 이를 모델과 워크로드부터 소프트웨어, 컴퓨팅, 네트워킹, 메모리까지 전체 스택을 하나의 시스템으로 최적화하는 ‘극한의 공동 설계’ 결과로 설명했다. 각 요소를 함께 설계해 제한된 전력에서 처리하는 토큰 수를 늘리고 토큰당 비용을 낮추는 방식이다.
A100도 6년째 운영…CUDA로 세대 간 활용 이어가
새로운 GPU가 등장하더라도 모든 워크로드가 최신 시스템을 요구하는 것은 아니다. 엔비디아는 워크로드의 복잡성과 요구 성능에 맞춰 이전 세대 GPU를 계속 활용할 수 있다는 점을 AI 팩토리의 유효 수명과 연결했다.
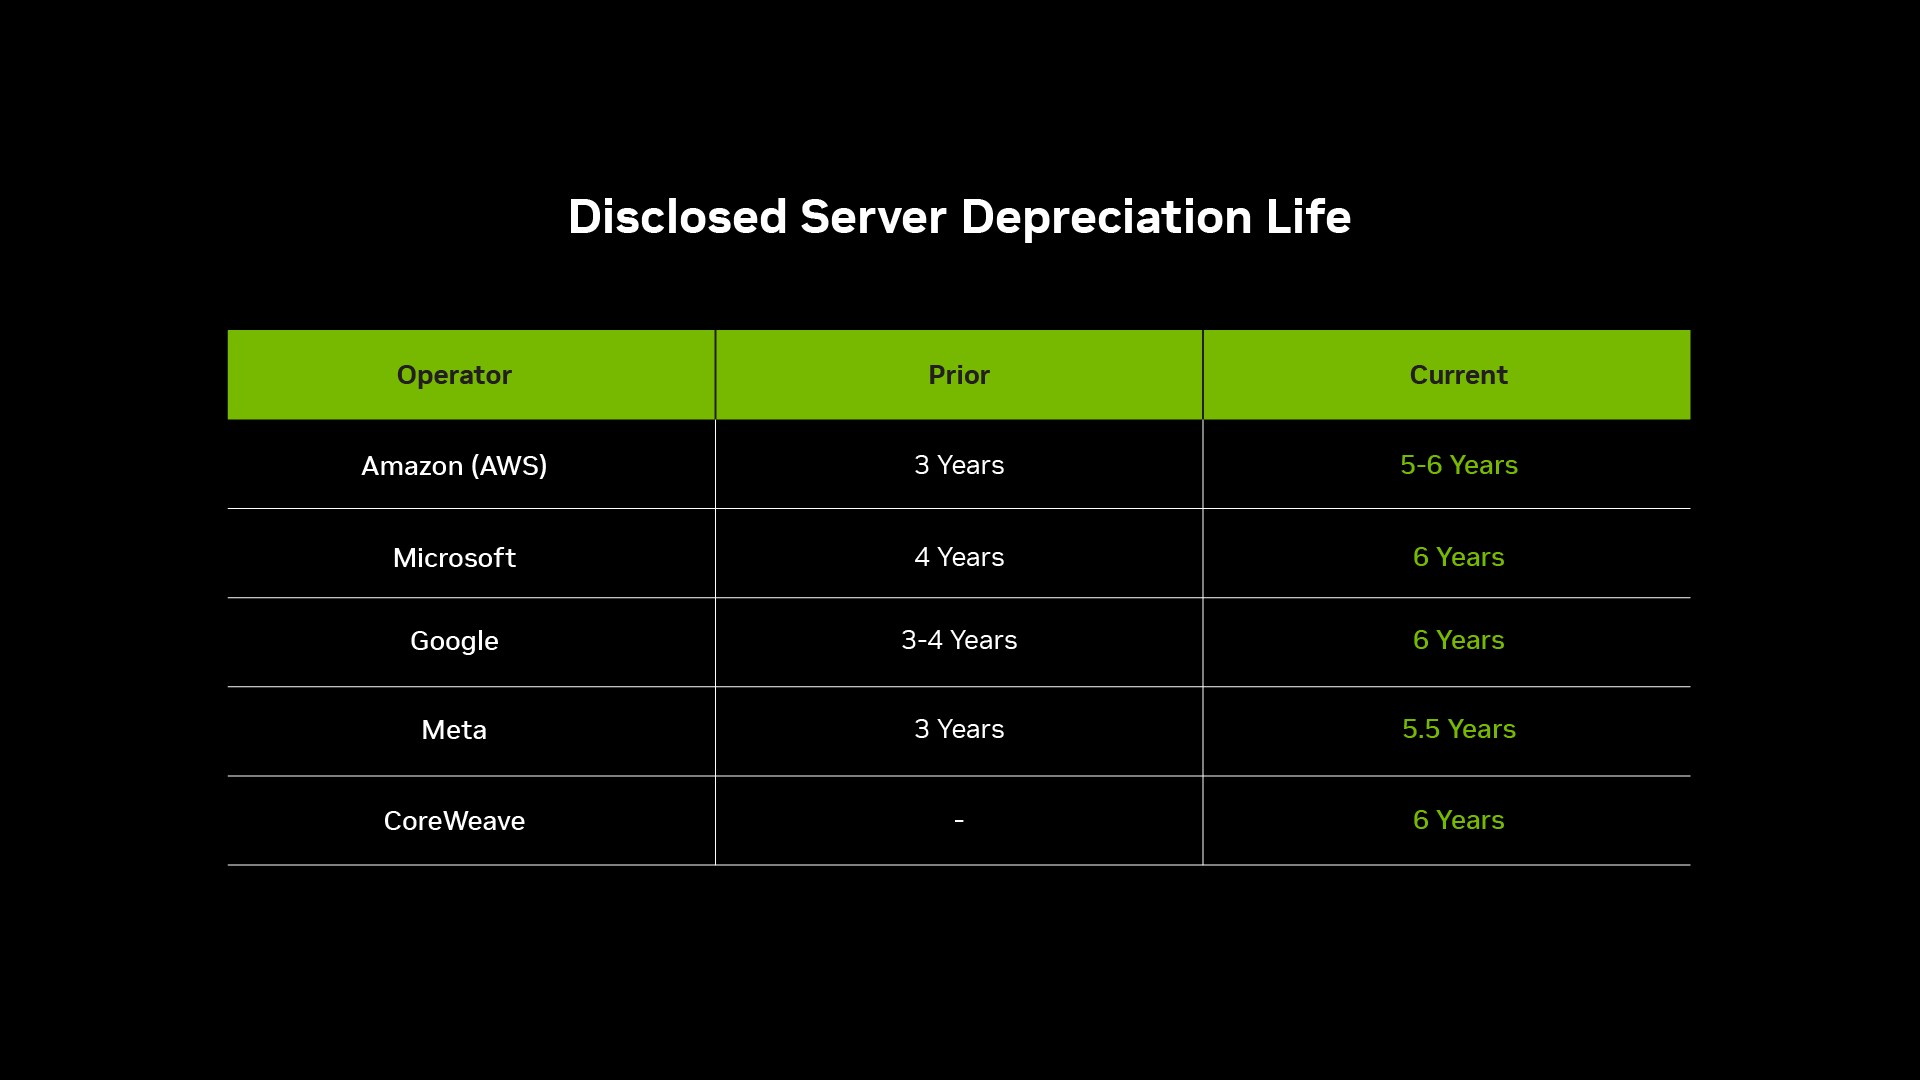
2020년 출시한 A100 GPU는 6년이 지난 현재도 상용 서비스에 사용되고 있다. 코어위브는 2020년 처음 도입한 A100 GPU의 주문 기간을 2029년까지 연장했다. 실리콘 데이터 자료에서도 A100은 출시 6년 뒤 초기 가격의 약 25%에 해당하는 가치를 유지하는 것으로 나타났다.
바커는 8개 GPU를 탑재한 H100 시스템의 유효 수명을 5~6년, GB300 NVL72는 9~10년으로 평가했다. 스프라우트 분석에서는 마이크로소프트의 V100 GPU가 회계상 내용연수 6년을 넘어 8.4년간 운영된 것으로 나타났다.
엔비디아는 여러 세대의 GPU를 지원하는 CUDA와 지속적인 소프트웨어·커널 최적화를 통해 기존 하드웨어의 활용 가치를 유지한다. 머신러닝과 딥러닝부터 생성형 AI, 추론, 에이전틱 AI, 피지컬 AI까지 다양한 워크로드를 동일한 플랫폼에서 실행해 이전 세대 GPU도 계속 활용한다.
AI부터 과학 컴퓨팅·시뮬레이션까지 하나의 GPU로
범용성은 AI 팩토리가 처리할 수 있는 작업의 범위를 넓혀 다양한 컴퓨팅 수요에 대응하는 기반이 된다. 특정 워크로드에 대한 수요가 달라지더라도 같은 GPU 인프라에서 다른 작업을 실행할 수 있어 활용 범위를 넓힐 수 있다.
엔비디아 플랫폼은 언어·비전·생물학·물리학·로보틱스 분야의 AI 모델을 비롯해 데이터 처리와 사전 학습, 사후 학습, 추론을 지원한다. 운영 환경도 하이퍼스케일·AI 클라우드에서 소버린 AI, 기업 데이터센터, 엣지까지 아우른다.
AI 이외의 데이터 처리와 과학 컴퓨팅, 시뮬레이션, 그래픽도 같은 인프라에서 실행한다. CUDA-X는 1000개 이상의 사전 구축 라이브러리를 제공하며 심층 신경망부터 계산 리소그래피, 양자 회로 시뮬레이션, 벡터 검색, 기후 모델링까지 다양한 가속 컴퓨팅 작업을 지원한다. 엔비디아에 따르면 1000만명 이상의 개발자가 CUDA 생태계를 기반으로 개발하고 있다.
텐서 코어와 트랜스포머 엔진은 프로그래밍 가능한 GPU 아키텍처에 AI 연산을 위한 전용 기능을 결합한다. 이를 통해 엔비디아 GPU는 특정 워크로드에 맞춘 ASIC과 달리 AI와 다양한 가속 컴퓨팅 작업을 하나의 아키텍처에서 처리한다.
신약 개발부터 금융·콘텐츠·시뮬레이션까지 적용
엔비디아 GPU는 산업별 실제 운영 환경에서도 서로 다른 워크로드에 활용되고 있다. 릴리는 1016개 GPU로 구성한 온프레미스 클러스터에서 단백질과 저분자, 유전체학 모델을 구축·운영하고 있으며 자체 챗봇과 에이전틱 워크플로우에도 활용한다.
핀터레스트는 블랙웰과 호퍼 등 여러 세대에 걸친 1만4000개 GPU를 사용해 비전 언어 모델을 사후 학습하고 배포한다. 레볼루트는 cuDF로 수십억 건의 거래 기록을 처리한 뒤 파운데이션 모델을 학습·배포하며, 런웨이는 호퍼에서 월드 모델을 학습하고 블랙웰 기반 클라우드 인프라에서 서비스를 제공한다.
텍사스 A&M 대학교는 슈퍼컴퓨터를 분자 시뮬레이션과 AI 신약 개발에 활용하며 26개 프로젝트와 7개 기관에 걸쳐 95~98%의 활용도를 기록하고 있다.
GPU 활용 범위는 AI 이외의 작업으로도 이어진다. 코즘은 고해상도 동영상 재생과 스트리밍, 실시간 그래픽에 엔비디아 기반 분산 데이터센터를 사용하며, 다쏘시스템은 항공기 인증과 차량 설계에 사용하는 버추얼 트윈 시뮬레이션을 지원한다. 유니레버는 디지털 트윈으로 제품 이미지를 제작해 제작 비용을 절반으로 줄였다.
#엔비디아 #NVIDIA #AI팩토리 #베라루빈 #VeraRubin #GB300NVL72 #CUDA #CUDAX #GPU #AI인프라 #데이터센터 #가속컴퓨팅 #AI추론 #ROI


