- 최대 40eTOPS·16GB LPDDR4 지원…산업 자동화·로봇·스마트 인프라로 적용 범위 확장
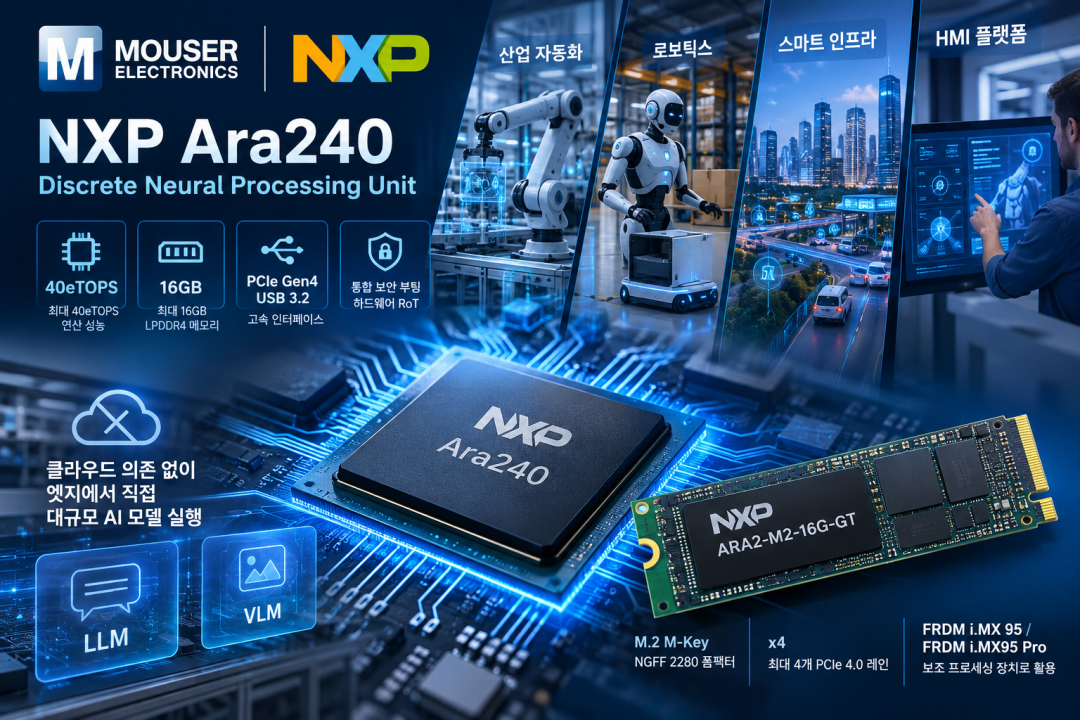
마우저 일렉트로닉스가 NXP 반도체의 디스크리트 신경망 프로세싱 유닛(DNPU) ‘Ara240’을 공급한다. Ara240은 대규모 언어 모델(LLM)과 비전 언어 모델(VLM)을 클라우드 컴퓨팅 자원에 의존하지 않고 엣지에서 직접 실행한다. 산업 자동화와 자율 로봇, 스마트 인프라, HMI 등 실시간 생성형 AI를 사용하는 환경을 겨냥했다.
엣지에서 대규모 AI 모델을 구동하려면 연산 성능뿐 아니라 모델 데이터를 빠르게 주고받을 메모리와 대역폭이 필요하다. Ara240은 컴퓨팅 성능과 높은 오프칩 대역폭을 결합하고 최대 40eTOPS의 연산 성능과 최대 16GB LPDDR4 메모리를 지원한다. 멀티모달과 트랜스포머 기반 워크로드까지 처리 범위를 넓혀 LLM과 VLM을 엣지에서 실행하면서 지연시간과 운영 비용을 낮추고 데이터 프라이버시를 높인다.
보안부터 호스트 연결까지 엣지 환경에 맞춰
산업과 기업, 임베디드 시스템에서 AI 모델을 직접 실행하는 만큼 보안 기능도 하드웨어에 담았다. Ara240은 통합 보안 부팅과 하드웨어 신뢰점(RoT) 프로세서를 갖춰 하드웨어 기반 보안 기능을 제공한다. PCIe Gen4와 USB 3.2 호스트 인터페이스를 이용해 엣지 컴퓨팅 플랫폼은 물론 PC와 노트북, AI 지원 임베디드 시스템에도 연결한다.
Ara SDK, CNN부터 LLM·VLM까지 하나의 개발 환경에서 지원
하드웨어에서 AI 모델을 실행하는 과정은 Ara SDK가 담당한다. 확장형 AI 컴파일러가 합성곱 신경망(CNN)과 완전 연결 신경망(FCNN), 비전 트랜스포머(ViT)를 비롯해 LLM과 VLM까지 다양한 모델 아키텍처를 지원한다. 개발자는 Ara240 기반 DNPU와 모듈에 필요한 AI 워크로드를 적용하고 애플리케이션 개발을 진행한다. 모델 처리 과정에서는 효율적인 데이터 흐름 최적화와 유연한 양자화 방식, 다양한 데이터 유형을 지원한다. 서로 다른 AI 모델을 Ara240에서 처리하는 과정에 이들 기능을 적용해 엣지 AI 애플리케이션의 높은 성능과 낮은 지연시간을 구현하고 개발 속도를 높인다.
M.2 모듈로 i.MX 95에 AI 연산 추가
마우저는 Ara240을 탑재한 AI 가속기 모듈 ‘ARA2-M2-16G-GT’도 공급한다. M.2 M-Key 규격에 NGFF 2280 폼팩터를 적용했으며, x4 구성으로 최대 4개의 PCI Express 4.0 레인을 지원한다. ARA2-M2-16G-GT는 M.2 M-Key PCI Express 기능을 갖춘 FRDM i.MX 95와 FRDM i.MX95 Pro 개발 보드에 보조 프로세싱 장치로 연결한다. Ara240의 AI 연산을 M.2 모듈 형태로 결합하는 방식이다.
#마우저일렉트로닉스 #NXP반도체 #Ara240 #DNPU #엣지AI #생성형AI #LLM #VLM #산업자동화 #로보틱스


