- 라마 3.1에 크메르어 20만 문장 추가 학습…출처 표기·RBAC·감사 로그 적용
- 연구 논문 ICEGOV 2026 채택…KOICA 캄보디아 AI 생태계 사업과 연계
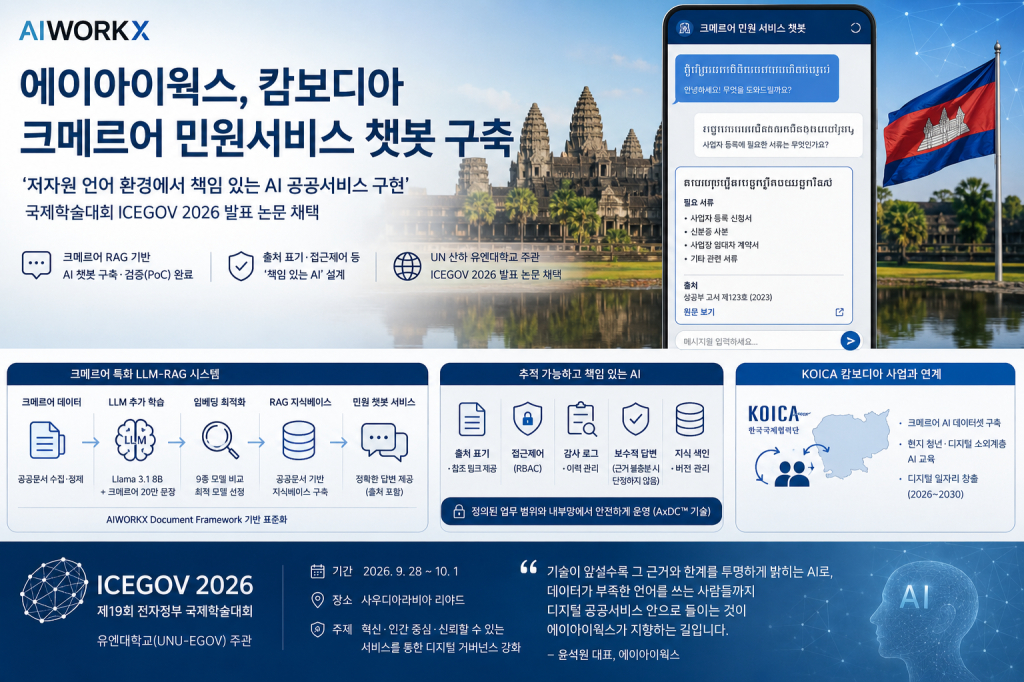
에이아이웍스가 캄보디아 국가 공공기관 민원 서비스를 대상으로 크메르어 검색증강생성(RAG) 기반 AI 챗봇 실증을 완료했다. 메타 라마 3.1 8B에 크메르어 약 20만 문장을 추가 학습하고 공공문서를 지식베이스로 연결해 민원 절차와 필요 서류를 크메르어로 안내하도록 구성했다. 답변에는 원문 출처와 참조 링크를 함께 제공하고 역할 기반 접근제어(RBAC), 감사 로그, 색인 버전 관리 등을 적용해 공공서비스에서 요구되는 추적 가능성과 책임성을 함께 검증했다.
저자원 언어 크메르어로 공공 민원 AI 구현
크메르어는 띄어쓰기 없이 문자가 이어지는 표기 방식과 복잡한 규칙 때문에 기존 다국어 AI 모델이 처리하기 어려운 저자원 언어로 분류된다. 2025년 생성형 AI 연구동향 분석에 따르면 국제 학계에 보고된 크메르어 생성형 언어모델 학습 데이터는 약 7만~57만9000문장 수준으로, 주요 언어와 비교해 학습 자원이 크게 부족하다. 에이아이웍스는 캄보디아 국가 단위 공공기관 민원 서비스를 대상으로 크메르어 AI 챗봇 PoC를 진행했다. 기반 모델이 크메르어를 얼마나 이해하는지 확인하고, 제한된 언어 자원에서도 RAG를 이용해 공공문서 기반 답변을 제공할 수 있는지를 검증했다. 실제 서비스 구축은 올해부터 단계적으로 추진하고 있다.
라마 3.1에 크메르어 20만 문장 추가 학습
연구진은 모델과 검색, 데이터 세 영역을 크메르어 환경에 맞췄다. 메타 라마(Llama) 3.1 8B 오픈 웨이트 모델에 한국지능정보사회진흥원(NIA)의 크메르어 말뭉치 약 20만 문장을 추가 학습하고 지시문 튜닝을 적용했다. 검색 단계에서는 9종의 다국어 임베딩 모델을 비교해 크메르어 검색 정확도가 가장 높은 모델을 선정했다. 현지 공공문서는 수집·정제·표준화한 뒤 RAG 지식베이스로 연결하고, 실제 민원과 유사한 수백개 질문으로 답변 품질을 평가했다. 문서 처리와 운영 과정은 ‘에이아이웍스 도큐먼트 프레임워크(AIWORKX Document Framework)’를 이용해 표준화했다.
출처·접근권한·감사 로그로 답변 근거 추적
이번 챗봇은 답변마다 원문 출처와 참조 링크를 제공한다. 근거가 충분하지 않을 때는 단정적인 답변을 피하고, 역할 기반 접근제어와 감사 로그, 지식 색인 버전 관리까지 적용해 어떤 자료를 기반으로 답변했는지 추적하도록 했다. 이 방식은 정의된 업무 범위와 내부망, 통제된 환경에서 LLM을 운영하는 에이아이웍스의 ‘AxDC(Controllable LLM)’ 기술 방향과 연결된다. 공공서비스에서 잘못된 답변이나 근거 없는 추정을 줄이고, 답변 과정과 사용 데이터를 관리하는 데 초점을 맞췄다. 예비 평가에서는 크메르어 MMLU 형식 벤치마크에서 추가 학습 모델의 성능 향상을 확인했다. LLM 평가자(LLM-as-a-Judge)를 활용한 민원 시나리오 평가에서도 제안 시스템이 비교 대상 가운데 가장 높은 성능을 기록했다.
KOICA 사업과 연계해 크메르어 AI 데이터 확대
에이아이웍스는 데이터와 언어기술, 모델, 인프라를 중심으로 단일 민원 서비스에서 여러 부처로 적용 범위를 넓히고 장기적으로 전국 단위 서비스로 확장하는 로드맵을 제시했다. 대규모 실제 서비스 적용을 위해서는 추가 검증을 진행할 예정이다. 회사는 지난 4월 한국국제협력단(KOICA) IBS 사업인 ‘캄보디아 프놈펜 AI 생태계 조성과 디지털 일자리 창출 사업(2026~2030)’을 수주했다. 해당 사업을 통해 크메르어 AI 데이터셋을 구축하고 현지 청년과 디지털 소외계층을 대상으로 AI 교육과 고용 연계를 추진하며, 이번 민원 챗봇 기술을 기반으로 활용한다.
ICEGOV 2026서 저자원 언어 책임 AI 사례 발표
이번 연구를 담은 논문 ‘저자원 언어 환경의 책임 있는 AI 공공서비스를 위한 추적 가능한 LLM-RAG: 크메르어 사례연구(Traceable LLM-RAG for Responsible AI-Enabled Public Services in Low-Resource Language Contexts)’는 지난 7월 제19회 전자정부 국제학술대회 ‘ICEGOV 2026’ 발표 논문으로 채택됐다. ICEGOV 2026은 유엔대학교 산하 UNU-EGOV와 프린스술탄대학교가 주최하며 사우디 디지털정부청이 후원한다. 행사는 오는 9월 28일부터 10월 1일까지 사우디아라비아 리야드에서 열리며, 에이아이웍스도 현장에서 연구 성과를 발표할 예정이다.
에이아이웍스 윤석원 대표는 “생성형 AI가 빠르게 확산되고 있지만 답변의 근거를 추적하고 오류를 검증할 수 있어야 이용자가 신뢰할 수 있는 서비스가 된다”며 “저자원 언어는 학습 데이터가 적어 잘못된 답변을 생성할 위험이 큰 만큼 근거를 밝히는 책임 있는 AI 설계가 디지털 포용의 전제 조건”이라고 밝혔다.
#에이아이웍스 #AIWORKX #크메르어 #RAG #책임있는AI #저자원언어 #LLM #공공서비스AI #ICEGOV2026 #KOICA #캄보디아 #AxDC
 클루커스, OpenAI Select Partner 선정…기업 AI 도입부터 운영·확...
 알리바바, 최대 30초 영상 생성 ‘Wan3.0’ 베타 공개…PDF·웹페이지...


