


- 지포스 RTX 5090 단일 GPU에서 MTP 적용…라마.cpp·올라마·언슬로스·LM 스튜디오 바이오닉 지원
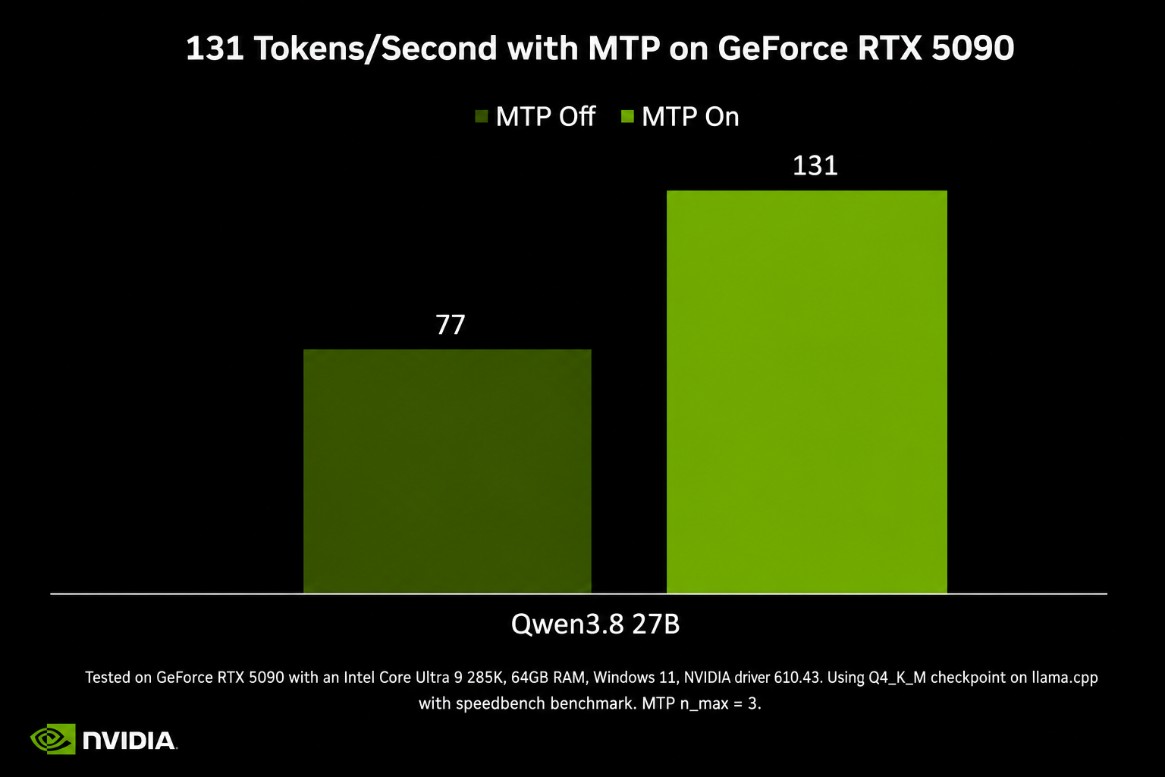
엔비디아가 RTX GPU에서 270억 파라미터 규모 오픈 모델 ‘큐원3.8-27B(Qwen3.8-27B)’를 지원한다. 큐원3.8-맥스(Qwen3.8-Max)의 로컬 동반 모델로 설계된 이 모델은 로컬 파일과 도구, 프로젝트 컨텍스트를 활용해 코딩 작업을 수행하며, 다중 토큰 예측(MTP)을 적용하면 단일 지포스 RTX 5090에서 초당 131토큰의 추론 성능을 제공한다. 개발자는 코드와 독점 데이터, 프로젝트 정보를 자체 시스템에 유지한 채 에이전틱 코딩과 장시간 개발 작업에 활용할 수 있다.
270억 파라미터 모델을 단일 RTX GPU에서 구동
큐원3.8-27B는 270억 파라미터 규모의 오픈 모델로, 단일 GPU에서 실행하면서 로컬 코딩 워크플로우를 처리한다. 파일과 개발 도구, 프로젝트 컨텍스트를 모델과 연결해 코드 생성과 수정뿐 아니라 여러 단계에 걸친 작업도 로컬 환경에서 이어갈 수 있다. 지원 대상은 엔비디아 RTX PRO GPU와 지포스 RTX 5090을 포함한 RTX GPU다. 모델 연산을 클라우드로 넘기지 않아도 돼 민감한 코드와 독점 데이터, 개발 과정에서 생성되는 프로젝트 정보를 자체 시스템에 유지할 수 있다.
MTP 적용해 RTX 5090서 초당 131토큰
큐원3.8-27B는 다중 토큰 예측으로 최적화됐으며, MTP를 적용할 경우 단일 지포스 RTX 5090에서 초당 131토큰을 처리한다. 해당 수치는 인텔 코어 울트라 9 285K와 64GB RAM, 윈도우 11, 엔비디아 드라이버 610.43 환경에서 라마.cpp의 Q4_K_M 체크포인트와 스피드벤치 벤치마크를 사용해 측정했다. MTP는 한 번의 추론 과정에서 여러 토큰을 예측해 생성 속도를 높이는 방식으로, 에이전틱 코딩과 도구 사용처럼 반복적인 추론이 이어지는 작업에서 반응 시간을 줄이는 데 활용된다. 장시간 개발 작업에서도 로컬에서 빠른 응답을 유지하는 것이 목표다.
라마.cpp·올라마 등 오픈소스 도구 지원
개발자는 라마.cpp와 올라마(Ollama), 언슬로스(Unsloth), LM 스튜디오 바이오닉(LM Studio Bionic)을 통해 큐원3.8-27B를 실행할 수 있다. 각 도구가 엔비디아 RTX GPU를 지원해 기존 로컬 AI 개발 환경에서도 모델을 바로 활용하도록 했다. 엔비디아는 RTX GPU의 연산 성능과 쿠다(CUDA) 소프트웨어 생태계를 기존 오픈소스 도구와 연결해 로컬 에이전틱 코딩 환경을 제공한다. 별도의 폐쇄형 실행 환경에 모델을 묶지 않고 개발자가 사용하는 도구에서 동일 모델을 선택하는 방식이다.
DGX 스파크·스테이션에서 젯슨까지 확대
큐원3.8-27B는 DGX 스파크와 DGX 스테이션에서도 지원한다. 엔비디아는 로컬 AI 디바이스 전반에 NVFP4를 적용하는 추가 최적화 기능도 공개할 예정이며, 개인용 AI 시스템에서 상시 구동하는 코딩 에이전트로 활용 범위를 넓힐 계획이다. 지원 범위는 PC를 넘어 젯슨까지 이어진다. 젯슨에서는 MTP를 활용한 추측 디코딩(speculative decoding)을 적용해 엣지 환경에서도 로컬 추론을 수행하며, 큐원3.8-27B의 코딩과 에이전틱 기능을 기기 내부에서 실행한다.
#엔비디아 #Qwen38 #큐원38 #Qwen3827B #RTX5090 #RTXGPU #로컬AI #코딩에이전트 #에이전틱AI #MTP #CUDA #DGXSpark #Jetson
 티맥스소프트, 상반기 공공 AI·DX 수주 확대…하반기 차세대 사업 ...
 스노우플레이크, 이용석 신임 한국 지사장 선임…국내 AI 데이터 ...


