- 최대 100만 토큰 컨텍스트 지원…고강도 추론서 토큰 35%·작업당 평균 비용 60% 절감
알리바바 그룹이 총 2조4000억개의 파라미터를 갖춘 ‘큐웬4-Max(Qwen4-Max)’를 공개했다. 큐웬4-Max는 토큰을 처리할 때마다 710억개의 파라미터만 활성화하는 희소 전문가 혼합(MoE) 모델로, 네이티브 비전 기능과 최대 100만 토큰의 컨텍스트 윈도우를 지원한다. 코딩과 에이전틱 작업, 시각 추론을 비롯해 업무와 창작, 연구 분야의 복잡한 과제를 처리한다.
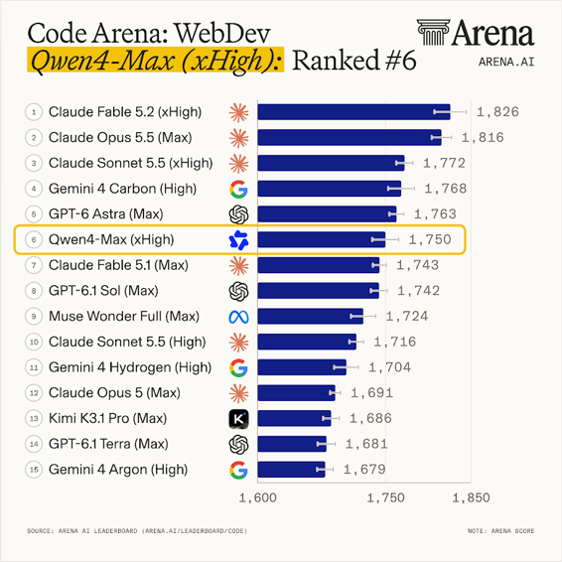
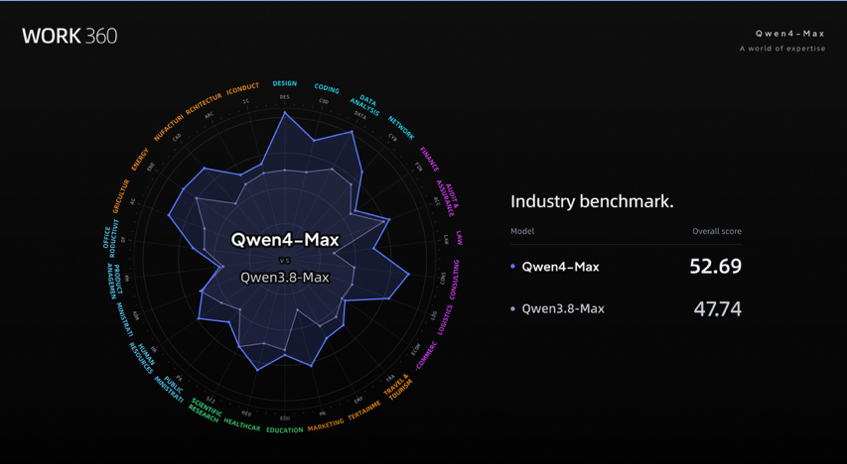
큐웬4-Max는 실제 코딩 성능을 평가하는 코드 아레나에서 6위에 올랐다. 에이전트 워크플로와 업무 생산성, 시각 추론을 평가하는 에이전츠 라스트 이그잼(Agents' Last Exam), 발스 인덱스(Vals Index), 잡벤치(JobBench), 차토그래피(Chartography) 등에서도 상위권 성적을 기록했다. 721개 전문 분야의 고난도 산업 과제를 평가하는 알리바바 자체 벤치마크 워크360(Work360)에서는 이전 모델인 큐웬3.8-Max보다 전반적으로 높은 성능을 보였다. 높은 추론 강도(High effort) 설정에서는 토큰 사용량을 35% 줄였으며, 작업당 평균 비용도 약 60% 절감했다.
2.4조 파라미터 중 710억개 활성화
큐웬4-Max는 어텐션과 잔차 연결(residual connection), 임베딩 전반에 희소 전문가 혼합 설계를 고도화한 큐웬4 아키텍처를 적용했다. 전체 2조4000억개의 파라미터 가운데 토큰을 처리할 때마다 710억개만 활성화하며, 같은 2조4000억개 규모의 큐웬3.8-Max보다 활성 파라미터를 25% 줄였다. 이를 통해 추론 비용을 낮추면서 모델 성능을 높였다.
클라우드 자원 스케줄링부터 제조 공정까지 적용
큐웬4-Max는 클라우드 인프라에서 자원을 배분하는 클라우드 자원 스케줄링(CRS) 기능을 갖췄다. 이 기능은 폐쇄 루프 방식으로 스케줄링 작업을 자율적으로 최적화해 비용을 줄이고 자원 활용 효율을 높인다. 벤치마크에서는 데이터 어노테이션 작업에 필요한 모델 호출 비용이 평균 9% 감소했으며, 오프라인 CPU 재스케줄링 속도는 14배 이상 빨라졌다.
큐웬4-Max는 3D 모델링과 게임 개발, 에이전틱 영상 제작 등 전문 작업과 콘텐츠 제작도 지원한다. 자동차 제조 분야에서는 생산라인 계획 수립부터 부품 설계와 가공 검증까지 전 과정을 지원하며, 실제 시연에서는 피드백을 반복적으로 반영해 가공 전 과절삭이나 소재 제거 부족 문제를 사전에 파악했다. 공작물 가공 프로그램의 수작업 작성 시간은 약 475분에서 24분으로 95% 단축됐다. 금융과 법률, 의료 분야에서는 현장 밀착형 엔지니어링(FDE)을 보다 신속하게 수행하도록 지원한다.
48시간 연속 에이전트 실행…냉각제 분자 발견
큐웬4-Max는 장시간에 걸쳐 작업을 자율적으로 수행한다. 과학 분야에서는 장기 계획(long-horizon planning)을 활용해 디지털 환경에서 진행하는 연구와 실제 실험을 연결한다. 차세대 칩 냉각 연구에서는 큐웬4를 48시간 동안 연속 실행하며 폐쇄 루프 기반 연구 과정을 네 차례 반복했다. 분자 설계와 합성·실험, 능동 학습(active learning)을 결합한 이 과정을 통해 실제 실험으로 성능이 검증된 냉각제 분자를 발견했다.
알츠하이머 연구 실험에서는 큐웬4-Max가 관련 표적 연구부터 분자 설계와 컴퓨터 기반 평가까지 수행했다. 이 과정에서 454회의 도구 호출과 3239회의 평가 지표 검토를 자율적으로 진행하며 24개 후보 분자를 설계하고 최적화했다.
모델 전 생애주기에 보안·안전 거버넌스 적용
알리바바는 모델 거버넌스를 모델의 전 생애주기에 걸쳐 적용했다. 소프트웨어 엔지니어링 분야의 모델 학습 과정에서는 기능 테스트와 코드 보안 점검을 병행해 인젝션 공격과 메모리 안전성 문제, 접근 제어 결함 등의 취약점을 줄였다. 사이버보안 관련 학습 데이터는 작업 목적에 따라 선별해 취약점 탐지와 개선에 필요한 방어 목적의 자료는 유지하고 공격에 활용될 수 있는 콘텐츠는 제거했다. 전용 안전 데이터셋과 추가 학습을 통해 화학·생물·방사능·핵(CBRN) 위험에 대한 보호 장치도 강화했다.
QwenCloud·API 제공…오픈 웨이트 모델도 공개 예정
큐웬4-Max는 현재 QwenCloud에서 토큰 플랜과 API로 제공되며, QwenWork와 QwenStudio에서도 이용할 수 있다. 캐시 적중이 적용된 입력 토큰 요금은 100만 토큰당 0.075달러다. 알리바바는 큐웬4 시리즈의 소규모 오픈 웨이트 모델을 전 세계 개발자에게 공개할 예정이다.
#알리바바 #큐웬 #큐웬4Max #Qwen4Max #에이전틱AI #생성형AI #MoE #AI에이전트 #멀티모달AI #클라우드AI #과학AI
 유니티, 인디 스튜디오 지원 ‘유니티 펠로우십’ 출범…10개 팀에 5...
 데이터이쿠 ‘헤드리스’ 발표…코딩 에이전트에 데이터·AI 거버넌스...


