- 1.25T 모델 체크포인팅 쓰기 877.52GiB/s…Llama 3.1 8B KV 캐시 초당 8만5736토큰 처리
에버퓨어(구 퓨어스토리지)가 엠엘퍼프 스토리지 v3.0(MLPerf Storage v3.0) 벤치마크의 405B·1.25T 매개변수 모델 체크포인팅과 키·값 캐시(KV 캐시) 부문에서 모두 1위를 기록했다. 플래시블레이드//EXA(FlashBlade//EXA)는 가속기 1024개를 시뮬레이션한 환경에서 1.25T 모델의 체크포인트를 877.52GiB/s로 저장했다. 추론용 Llama 3.1 8B 워크로드에서는 스토리지만으로 초당 8만5736토큰을 처리했다.
AI 학습에서 체크포인트 저장이 늦어지거나 추론 과정에서 KV 캐시를 제때 읽지 못하면 GPU와 가속기가 데이터를 기다리며 유휴 상태에 들어간다. 컴퓨팅 자원을 늘리더라도 스토리지 처리량이 따라오지 못하면 학습·추론 시간이 길어지고 운영 비용도 증가한다.
에버퓨어 롭 리(Rob Lee) 최고기술·성장책임자는 “이번 결과는 플래시블레이드//EXA가 AI 워크로드의 높아지는 요구에 맞춰 성능과 확장성을 제공한다는 점을 보여준다”며 “AI 개발 조직은 안정성과 운영 편의성을 유지하면서 성능과 용량을 확장할 수 있는 인프라가 필요하다”고 밝혔다.
KV 캐시에서 초당 8만5736토큰 처리
추론 워크로드에서는 생성형 AI 모델이 이전 토큰을 처리하며 생성한 키·값 데이터를 KV 캐시에 저장하고, 다음 토큰을 만들 때 다시 불러온다. 모델을 대규모로 서비스할수록 KV 캐시의 저장·검색 속도가 전체 추론 처리량을 좌우한다.
플래시블레이드//EXA는 Llama 3.1 8B 워크로드의 스토리지 전용 구성에서 초당 8만5736토큰을 처리했다. 스토리지와 메모리를 함께 사용한 8B 구성은 초당 6만7642토큰, 스토리지만 사용한 70B 워크로드는 초당 3만3403토큰을 기록했다.
메타데이터와 데이터 전송 분리
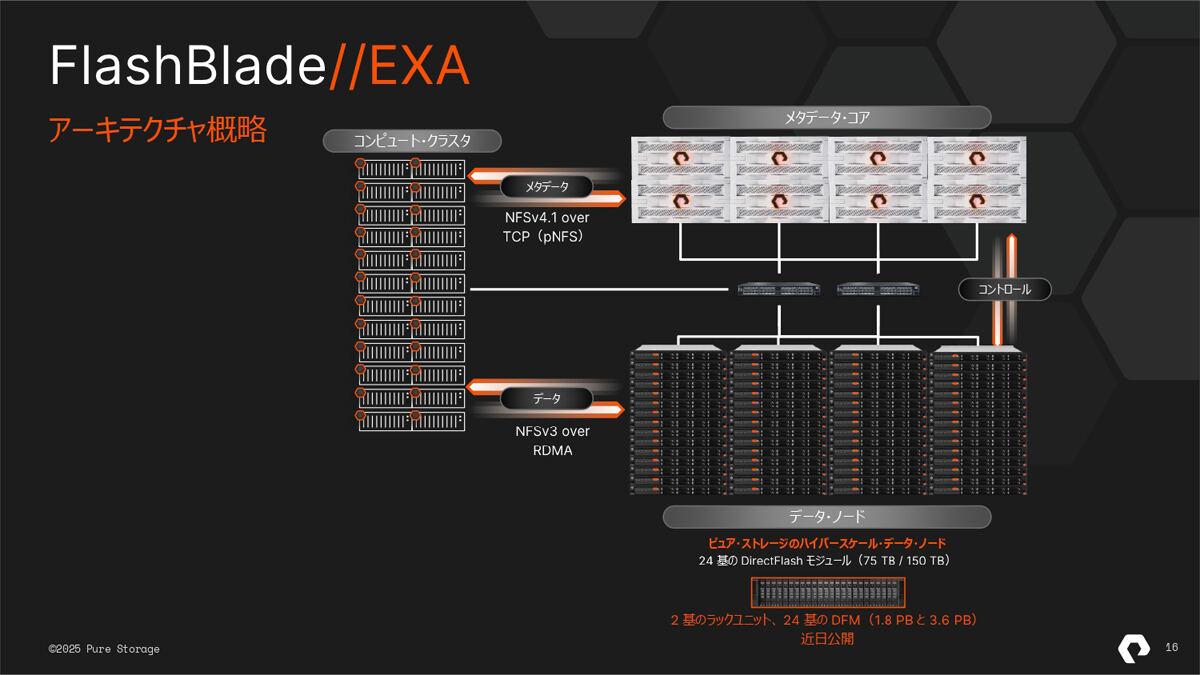
플래시블레이드//EXA는 메타데이터 관리와 실제 데이터 전송을 서로 분리한다. 벤치마크에는 플래시블레이드//EXA 블레이드 30개와 메타데이터 전용 다이렉트플래시 모듈(DirectFlash Modules) 120개를 투입했으며, Linux/NVMe 데이터 노드 30개를 연결했다. 통합 파일 시스템의 가용 용량은 약 866TB다.
클라이언트는 TCP 기반 NFSv4.1/pNFS로 파일의 저장 위치와 접근 경로를 확인한다. 경로가 정해지면 실제 데이터는 RoCEv2 기반 원격 직접 메모리 접근(RDMA)을 사용하는 NFSv3를 통해 전송된다. 데이터가 중앙에 집중된 경로를 거치지 않고 네트워크 패브릭을 통해 스토리지와 데이터 노드 사이를 직접 이동한다.
컴퓨팅 확대에 맞춘 용량·성능 확장
AI 환경은 GPU 수와 모델 매개변수, 학습 데이터, 저장 용량이 함께 늘어난다. 플래시블레이드//EXA는 데이터 노드를 추가해 용량과 처리량을 확장하며, 컴퓨팅 환경이 달라질 때마다 스토리지 시스템을 다시 설계하는 작업을 줄인다.
에버퓨어는 전통적인 스토리지 어레이를 넘어 엔터프라이즈 데이터 클라우드(Enterprise Data Cloud) 전략을 추진하고 있다. 엔터프라이즈 데이터 클라우드는 소프트웨어를 기반으로 여러 환경에 분산된 데이터를 통합 관리하고 활용하는 방식이다.
#에버퓨어 #퓨어스토리지 #FlashBladeEXA #MLPerfStorage #체크포인팅 #KV캐시 #Llama31 #AI스토리지 #RDMA #RoCEv2 #엔터프라이즈데이터클라우드
 EVG, CPO 양산 공정 지원…웨이퍼 본딩·NIL로 광 I/O 집적
 그룹아이비, NFC 중계 악성코드 ‘윈드릴레이(WindRelay)’ 발견…13...


