- 세미애널리시스 에이전트X서 GB300 NVL72와 비교…100만 토큰당 비용 최대 45배 낮춰
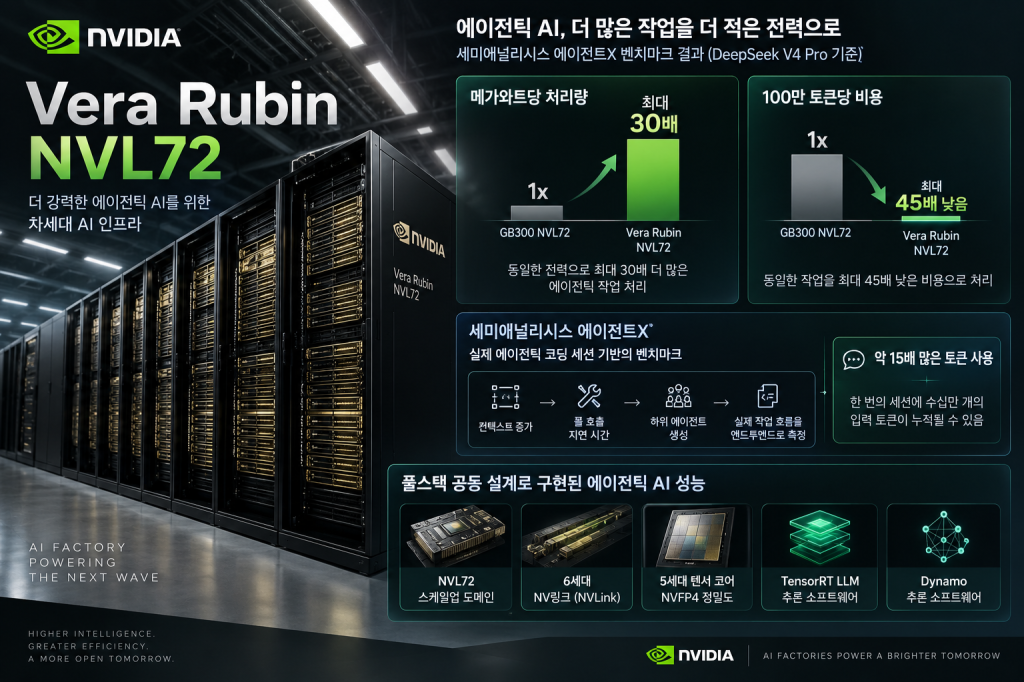
엔비디아가 ‘베라 루빈 NVL72(Vera Rubin NVL72)’의 에이전틱 AI 성능 결과를 세미애널리시스 에이전트X(SemiAnalysis AgentX) 대시보드에 공개했다. 에이전트X에서 딥시크 V4 프로(DeepSeek V4 Pro) 모델을 기준으로 측정한 결과, 베라 루빈 NVL72는 엔비디아 GB300 NVL72 대비 메가와트당 처리량이 최대 30배 높았으며 100만 토큰당 비용은 최대 45배 낮았다.
실제 에이전틱 코딩 세션으로 추론 성능 측정
세미애널리시스 에이전트X는 단일 요청 중심의 벤치마크와 달리 실제 기록된 에이전틱 코딩 세션을 기반으로 추론 성능을 측정한다. 작업이 진행되면서 증가하는 컨텍스트와 툴 호출 지연 시간, 하위 에이전트 생성 과정까지 반영한다.
에이전틱 워크로드에서는 에이전트가 추론과 툴 호출, 하위 에이전트 생성을 반복하면서 한 번의 세션에 수십만 개의 입력 토큰이 누적될 수 있다. 단순 채팅 요청보다 약 15배 많은 토큰을 사용하고, 요청마다 입력과 출력 길이의 편차도 크다. 에이전트X는 이 같은 작업 과정을 엔드투엔드로 측정해 다양한 모델과 시나리오에서 요청 단위 성능을 평가하는 MLPerf 추론(MLPerf Inference) 등 기존 표준 벤치마크를 보완한다.
메가와트당 처리량 최대 30배·토큰 비용 최대 45배 차이
에이전트X 결과에서 베라 루빈 NVL72는 딥시크 V4 프로 모델 기준 GB300 NVL72 대비 메가와트당 처리량을 최대 30배 높였고, 100만 토큰당 비용은 최대 45배 낮췄다. 이는 동일한 에너지 사용량으로 최대 30배 많은 에이전틱 작업을 처리한 결과다.
엔비디아는 전력 공급이 제한된 AI 팩토리에서 메가와트당 처리량이 동일한 전력으로 처리하는 에이전틱 작업 규모를 나타내고, 100만 토큰당 비용은 이를 처리하는 비용 효율을 보여주는 지표라고 설명했다.
NV링크·NVFP4부터 추론 소프트웨어까지 결합
베라 루빈 NVL72는 NVL72 스케일업 도메인과 6세대 NV링크(NVLink) 인터커넥트, 5세대 텐서 코어(Tensor Core)의 NVFP4 정밀도를 결합한다. 여기에 엔비디아 텐서RT LLM(TensorRT LLM)과 다이나모(Dynamo) 등 추론 소프트웨어를 함께 적용해 에이전틱 AI 워크로드를 처리한다. 베라 루빈은 현재 본격 양산 중이며, 엔비디아는 향후 소프트웨어 최적화를 통해 성능을 지속적으로 높일 계획이다.
#엔비디아 #NVIDIA #베라루빈 #VeraRubin #NVL72 #에이전트X #SemiAnalysis #에이전틱AI #딥시크V4프로 #DeepSeekV4Pro #NVLink #NVFP4 #TensorRTLLM #Dynamo #AI팩토리
 엔비디아, 베라 루빈·그록 3 LPX로 AI 추론 가속…전력당 토큰 최...
 엔비디아, DSX 플렉스로 AI 팩토리 전력 자동 조정…전력망 신호에...


